引言:当“智能”遇上“机密”,企业AI的隐私困境
在生成式AI重塑工作流程的今天,员工平均每隔三天就会将包含商业机密或个人身份信息(PII)的内容输入AI工具。然而,使用公有云API意味着数据必须离开企业内网,这不仅违反了《数据安全法》和GDPR等合规要求,更让企业面临“影子AI”带来的系统性数据泄露风险。
许多团队陷入二元误区:要么忍受云端API的隐私隐患,要么因本地部署的高门槛而放弃。事实上,如何在本地部署开源大模型以处理公司内部敏感文档而不泄露数据,已成为平衡生产力与安全性的关键命题。本文将融合最新技术实践,提供一套从基础设施到合规审计的完整落地方案。
为什么选择本地部署开源大模型?
与闭源云服务不同,本地部署开源模型(如Qwen2.5-7B、Llama 3.1)赋予了企业对数据的完全控制权:
- 数据不出内网:所有推理过程在本地服务器或NAS完成,杜绝第三方服务器记录风险。
- 模型可审计:开源权重和代码允许企业进行安全审查,避免后门。
- 成本可控:虽然初期硬件投入存在,但长期来看,避免了按Token计费的高昂订阅费用,且无数据留存合规风险。
第一步:基础设施与模型选型
1. 硬件准备:并非一定要顶级超算
对于大多数企业内部文档处理场景,7B-8B参数量的模型已能胜任。推荐配置如下:
- GPU:NVIDIA RTX 4090D或专业卡,显存≥24GB(支持FP16推理)。
- 内存:≥64GB,确保上下文加载流畅。
- 存储:高速SSD,用于存放模型权重和向量数据库。
若企业已有NAS设备(如QNAP),可通过Container Station直接部署Docker容器,利用PCIe扩展GPU,将传统存储升级为边缘AI算力中心。
2. 模型选择:性能与安全的平衡
Qwen2.5-7B:阿里云开源,中文理解能力强,支持128K长上下文,适合合同解析和长文档总结。
Llama 3.1-8B:Meta开源,生态丰富,多语言支持好,适合通用办公场景。
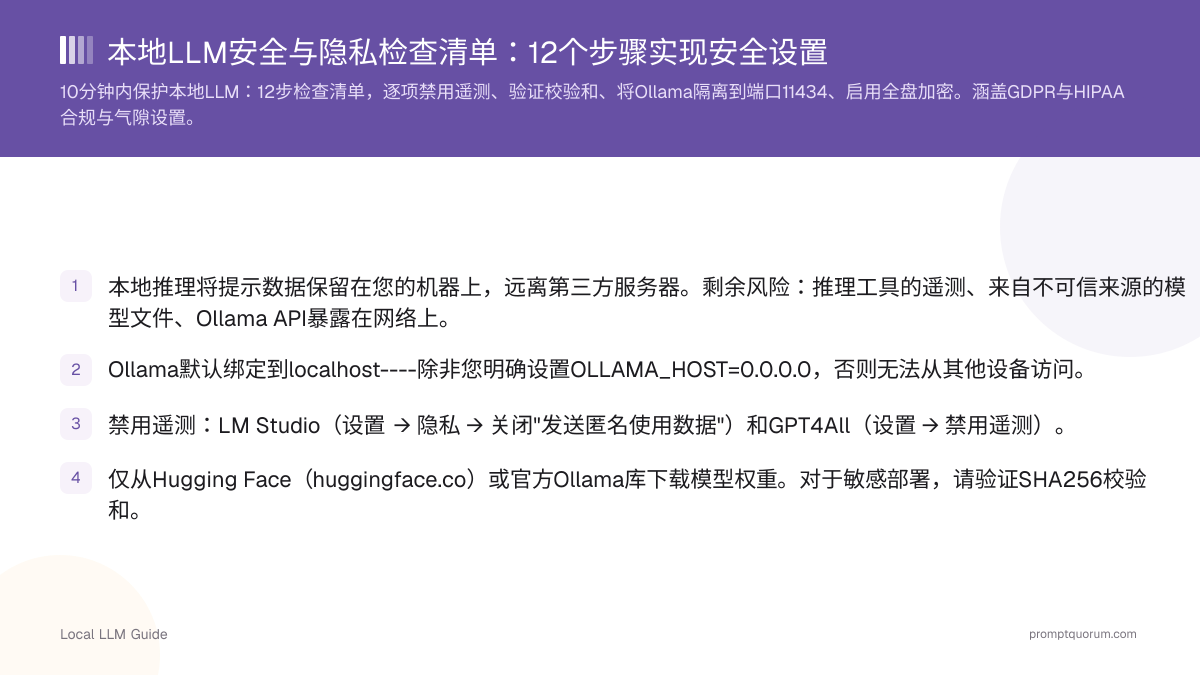
建议通过Hugging Face或官方Ollama库下载经过验证的GGUF量化版本,以减少内存占用并提升推理速度。
第二步:快速部署实战(Ollama + Docker)
相比复杂的原生Python环境,使用容器化部署是更安全、更易维护的选择。
方案A:Ollama一键启动(适合快速验证)
Ollama是目前最流行的本地LLM运行工具,支持自动管理模型卸载和GPU加速。
# 安装后运行命令
ollama run qwen2.5:7b注意:默认情况下Ollama仅绑定localhost。若需局域网访问,需配置环境变量OLLAMA_HOST=0.0.0.0,但务必配合防火墙规则使用。
方案B:Docker容器化部署(适合生产环境)
通过Docker隔离运行环境,可实现更细粒度的权限控制和日志审计。
docker run -d \
  --gpus all \
  --shm-size="16gb" \
  -p 8080:8000 \
  -v ./logs:/app/logs \
  --network=internal-net \
  --name qwen-7b \
  registry.example.com/qwen2.5-7b-inference:latest
此配置使用了自定义内网桥接(internal-net),从网络层面阻断了公网直接访问。
第三步:构建四层安全防护体系
仅仅“本地运行”并不等于“绝对安全”。以下是企业必须实施的四层增强策略:
1. 网络隔离与访问控制
- 物理/虚拟隔离:将模型部署在独立VPC或DMZ区,禁止直连互联网。
- 反向代理鉴权:使用Nginx + JWT验证API调用合法性,仅允许内部OA或CRM系统的IP段访问。
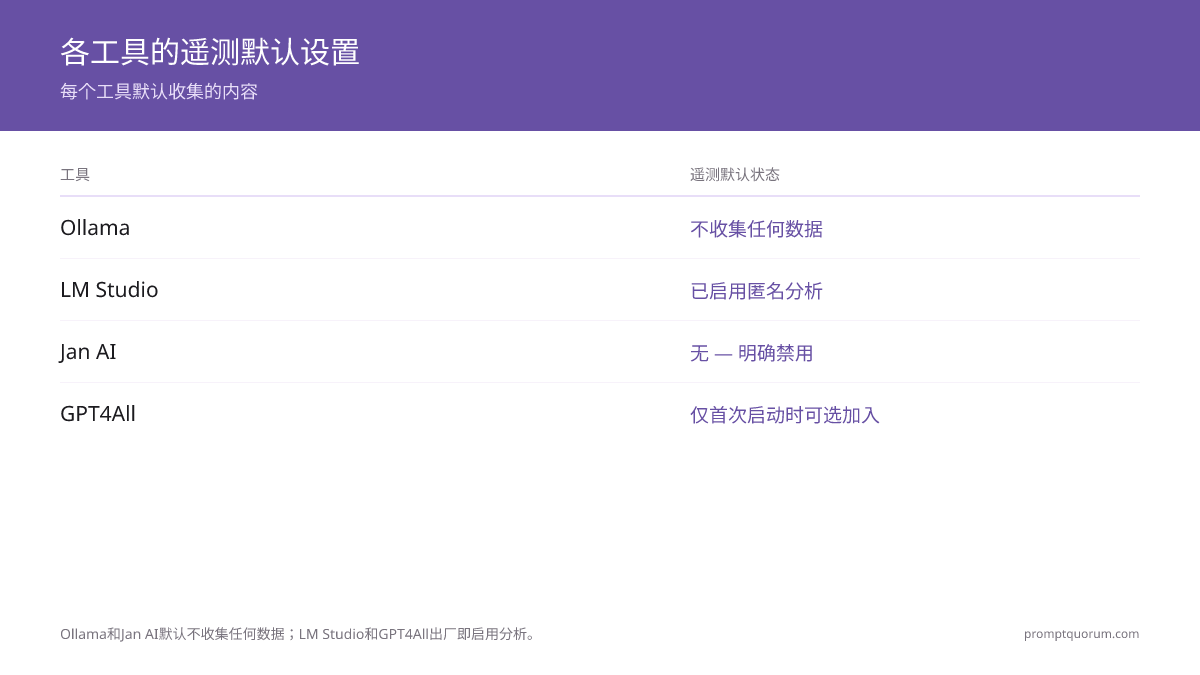
- 禁用遥测:检查所用工具(如LM Studio)的设置,关闭“发送匿名使用数据”选项,防止元数据泄露。
2. 输入输出内容审计与过滤
在数据进入模型前和结果返回前,建立双端审查机制:
- 输入侧脱敏:集成Microsoft Presidio或正则表达式,自动识别并替换身份证号、手机号、邮箱等PII信息为
[REDACTED]。 - 输出侧拦截:设置关键词黑名单(如“密码”、“密钥”),防止模型生成违规内容。
3. 日志留存与操作追溯
根据合规要求,保留至少6个月的操作日志。记录字段应包括时间戳、客户端IP、用户ID及输入内容的SHA256摘要(不存原文),以便事后审计。
4. 模型权限最小化
遵循最小权限原则,使用非root用户运行容器,限制磁盘写入路径,并启用Seccomp配置文件禁用不必要的系统调用。
第四步:进阶策略——混合路由与差分隐私
对于超大型企业,可采用“混合路由”策略:通过网关对查询进行分类,普通咨询路由至云端API以节省成本,而包含敏感数据(如医疗、财务)的查询则强制路由至本地私有集群。此外,对于统计分析场景,可引入差分隐私技术,在聚合数据中添加噪声,确保无法反推单个用户信息。
总结
在本地部署开源大模型不仅是技术升级,更是企业数据主权的重塑。通过选择合适的硬件、采用容器化部署、实施严格的网络隔离和内容审计,企业完全可以在享受AI红利的同时,筑牢数据安全的防线。记住,开源提供了安全的可能性,而严谨的工程实践才是安全的保障。