引言:敏感文档处理的“安全”与“效率”困局
在法律、金融及政务领域,合同与卷宗往往包含高度敏感的商业机密或个人隐私。传统的人工审核效率低下,而将文档上传至云端大模型进行解析又面临严峻的数据泄露风险。如何在不上传云端的情况下本地部署AI模型来批量解析敏感PDF合同并提取关键条款,成为企业智能化转型中必须跨越的技术门槛。
本文将融合多种开源技术方案,从底层架构到应用实践,为你构建一套100%本地闭环、零API成本且具备高精度结构化提取能力的解决方案。
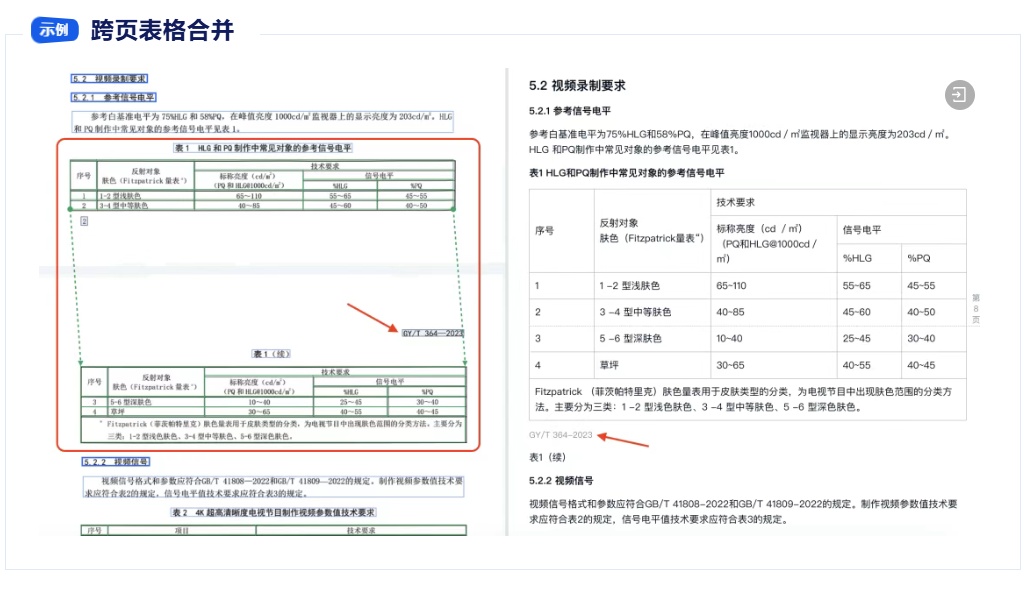
” alt=”大文件PDF解析性能瓶颈示意”>
核心痛点:为何传统方案难以胜任?
在处理数百页甚至上万页的合同卷宗时,开发者常遇到以下三大阻碍:
- 内存溢出(OOM):传统OCR或解析工具常采用“全量加载”模式,一次性将整份文档塞入内存。面对扫描版长文档,内存占用呈指数级攀升,导致服务崩溃。
- 结构丢失与幻觉:普通OCR仅能完成“像素转文字”,无法还原文档的逻辑结构(如跨页表格、合并单元格)。缺乏结构的文本传入大模型后,极易引发幻觉,导致关键条款提取错误。
- 数据合规风险:公有云API虽然便捷,但要求数据出域。对于内网隔离或对数据主权有严苛要求的机构,云端方案直接不可用。
技术选型:构建本地化AI解析流水线
为实现本地部署AI模型批量解析PDF,我们推荐组合使用以下开源组件,形成“视觉理解+语义提取+结构化存储”的闭环:
1. 视觉语言模型(VLM):DocExt
告别传统OCR,DocExt利用视觉语言模型(如Qwen-VL)直接“看懂”文档。它支持在Linux/macOS本地部署,无需上传云端即可精准提取字段和表格,并提供置信度评分,确保数据可靠性。
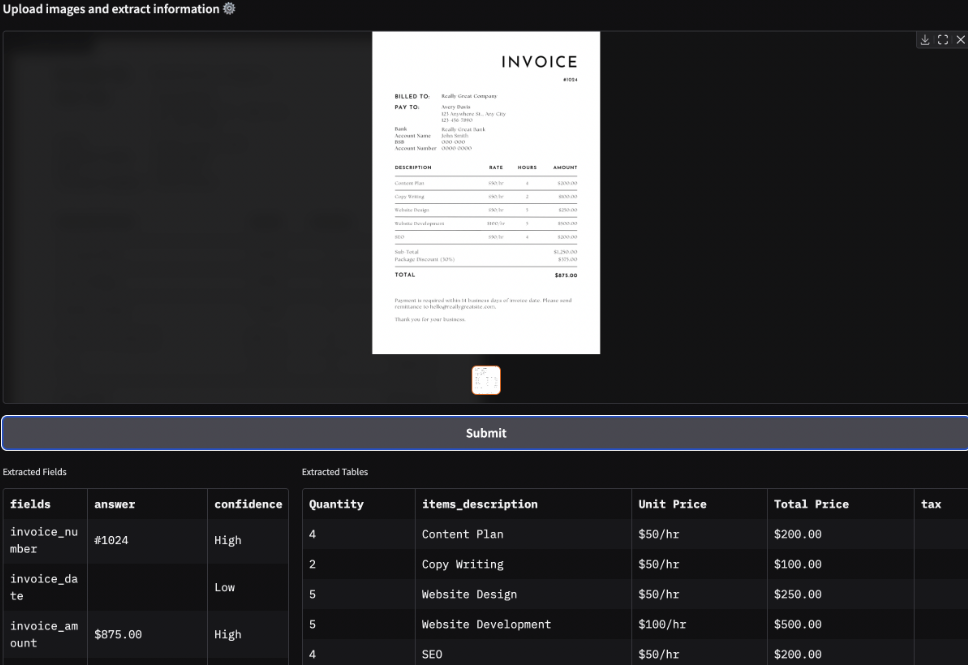
” alt=”DocExt无需OCR的结构化提取界面”>
2. 本地大语言模型:Ollama + DeepSeek
通过Ollama一键部署DeepSeek-R1或V3模型,提供OpenAI兼容的本地API接口。DeepSeek在逻辑推理与信息提取方面表现优异,且完全离线运行,彻底摆脱对云端算力的依赖。
3. 结构化提取框架:LangExtract
相比直接Prompt工程,LangExtract强制输出标准化的字段结构,支持少样本学习及结果溯源。它能有效抑制大模型幻觉,确保提取出的合同主体、金额、日期等关键信息格式统一且可追溯。
4. 检索与存储:Elasticsearch 9.x
用于持久化存储提取后的结构化数据,支持毫秒级的多条件筛选与全文检索,为后续的合同审查与RAG(检索增强生成)应用打下基础。
实战步骤:从零搭建本地解析环境
第一步:部署本地大模型底座
安装Ollama后,拉取适配硬件的DeepSeek模型(推荐7B版本以平衡速度与显存占用):ollama pull deepseek-r1:7b
验证本地API服务是否正常启动,确保地址为http://localhost:11434/v1。
第二步:配置DocExt进行文档预处理
通过pip安装DocExt,启动其本地Web界面或REST API。配置自定义模板,定义需要提取的合同字段(如发票号、签署方、终止日期等)。DocExt将PDF转换为带有结构信息的中间格式,保留表格与版式逻辑。
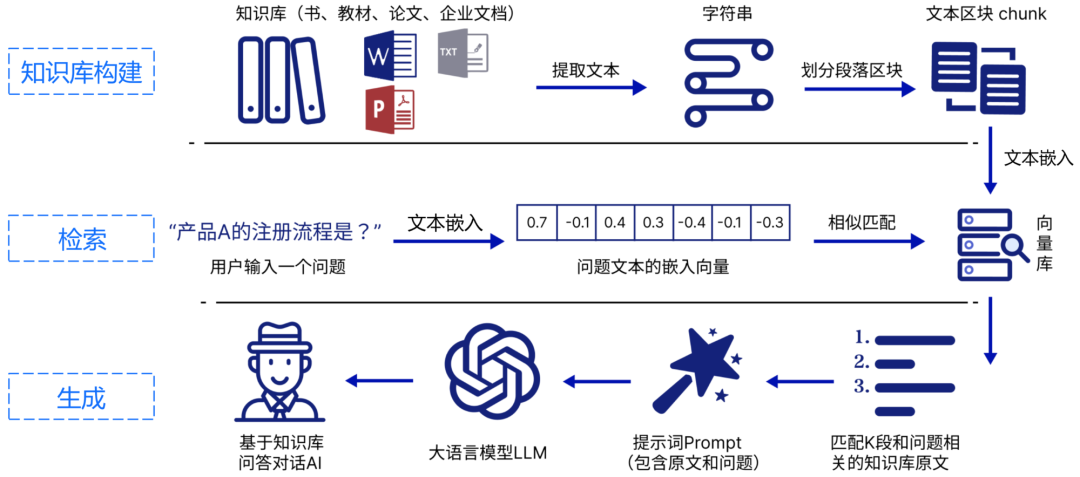
” alt=”RAG框架与本地知识库架构”>
第三步:集成LangExtract实现精准抽取
编写Python脚本,调用本地DeepSeek API。利用LangExtract的少样本示例功能,向模型展示标准的提取格式。程序将遍历本地文件夹中的PDF,逐份执行提取任务,并将结果校验后写入Elasticsearch。
# 核心逻辑示意
from langextract import extract
# 配置本地模型接口
config = {"api_base": "http://localhost:11434/v1", "model": "deepseek-r1:7b"}
result = extract(document_text, schema=contract_schema, config=config)
性能优化与注意事项
在处理大文件PDF解析时,需注意以下几点以提升稳定性:
- 流式处理:避免一次性加载整个PDF,建议按页或按章节切片处理,降低内存峰值。
- 硬件要求:运行7B参数模型建议至少配备16GB内存及8GB以上NVIDIA显存;若处理复杂版面,建议使用14B模型并搭配32GB内存。
- 离线运行:部署阶段需下载模型,但运行阶段可完全断开外网,满足物理隔离环境的合规要求。
总结
通过组合DocExt、Ollama与LangExtract,我们成功实现了在不上传云端的情况下本地部署AI模型来批量解析敏感PDF合同并提取关键条款的目标。这套方案不仅保障了数据的绝对隐私,还通过结构化提取提升了后续检索与分析的效率,是法律科技与金融合规领域值得采用的最佳实践。