引言:企业知识管理的隐私困境与AI破局
在数字化转型的浪潮中,企业内部积累了海量的文档、流程规范和技术方案。然而,传统关键词搜索往往难以理解语义,导致信息检索效率低下。与此同时,将敏感数据上传至公有云AI服务又引发了严重的数据隐私担忧。如何搭建基于私有文档的企业内部AI问答机器人以保护数据隐私,成为众多技术团队和管理者关注的核心议题。
通过结合检索增强生成(RAG)技术与本地化部署方案,企业可以在确保数据完全自主可控的前提下,赋予大语言模型(LLM)理解私有知识的能力。本文将深入探讨从技术选型、架构搭建到准确率优化的全流程实践。
一、 技术选型:主流RAG框架对比与决策
搭建AI问答机器人的第一步是选择合适的开发框架。目前市场上主流的RAG框架包括LangChain、LlamaIndex、Haystack和RAGFlow,它们各有侧重:
- LangChain:生态系统最庞大,适合构建复杂的AI代理和多步骤流水线,但学习曲线中等,且版本迭代较快。
- LlamaIndex:专为文档索引和检索设计,在处理复杂文档结构和多文档推理方面表现优异,适合以文档问答为核心场景的项目。
- Haystack:面向企业级NLP应用,提供可视化流水线构建器,适合需要高可靠性和审计轨迹的生产环境。
- RAGFlow:开箱即用的开源引擎,内置Web UI和高级文档解析能力,适合非技术团队快速部署内部知识库,无需编写大量代码。
对于追求快速落地且希望保护数据隐私的团队,RAGFlow或基于Dify的低代码平台是不错的选择;而对于需要高度定制化和复杂逻辑的企业,LangChain和LlamaIndex则提供了更大的灵活性。
二、 架构实战:本地化部署确保数据主权
要实现基于私有文档的安全问答,核心在于“数据不出本地”。以Dify为例,结合Rainbond等云原生管理平台,可以轻松实现企业级AI文档库的本地化部署。
部署过程中,关键在于配置本地的Embedding模型和大语言模型。Embedding模型充当“语义转换器”,将人类可读的文档转化为机器可计算的向量。推荐使用BGE-M3等支持中文且商用免费的模型,通过Ollama等工具在本地运行,确保所有数据处理均在内部服务器完成,彻底规避云端泄露风险。
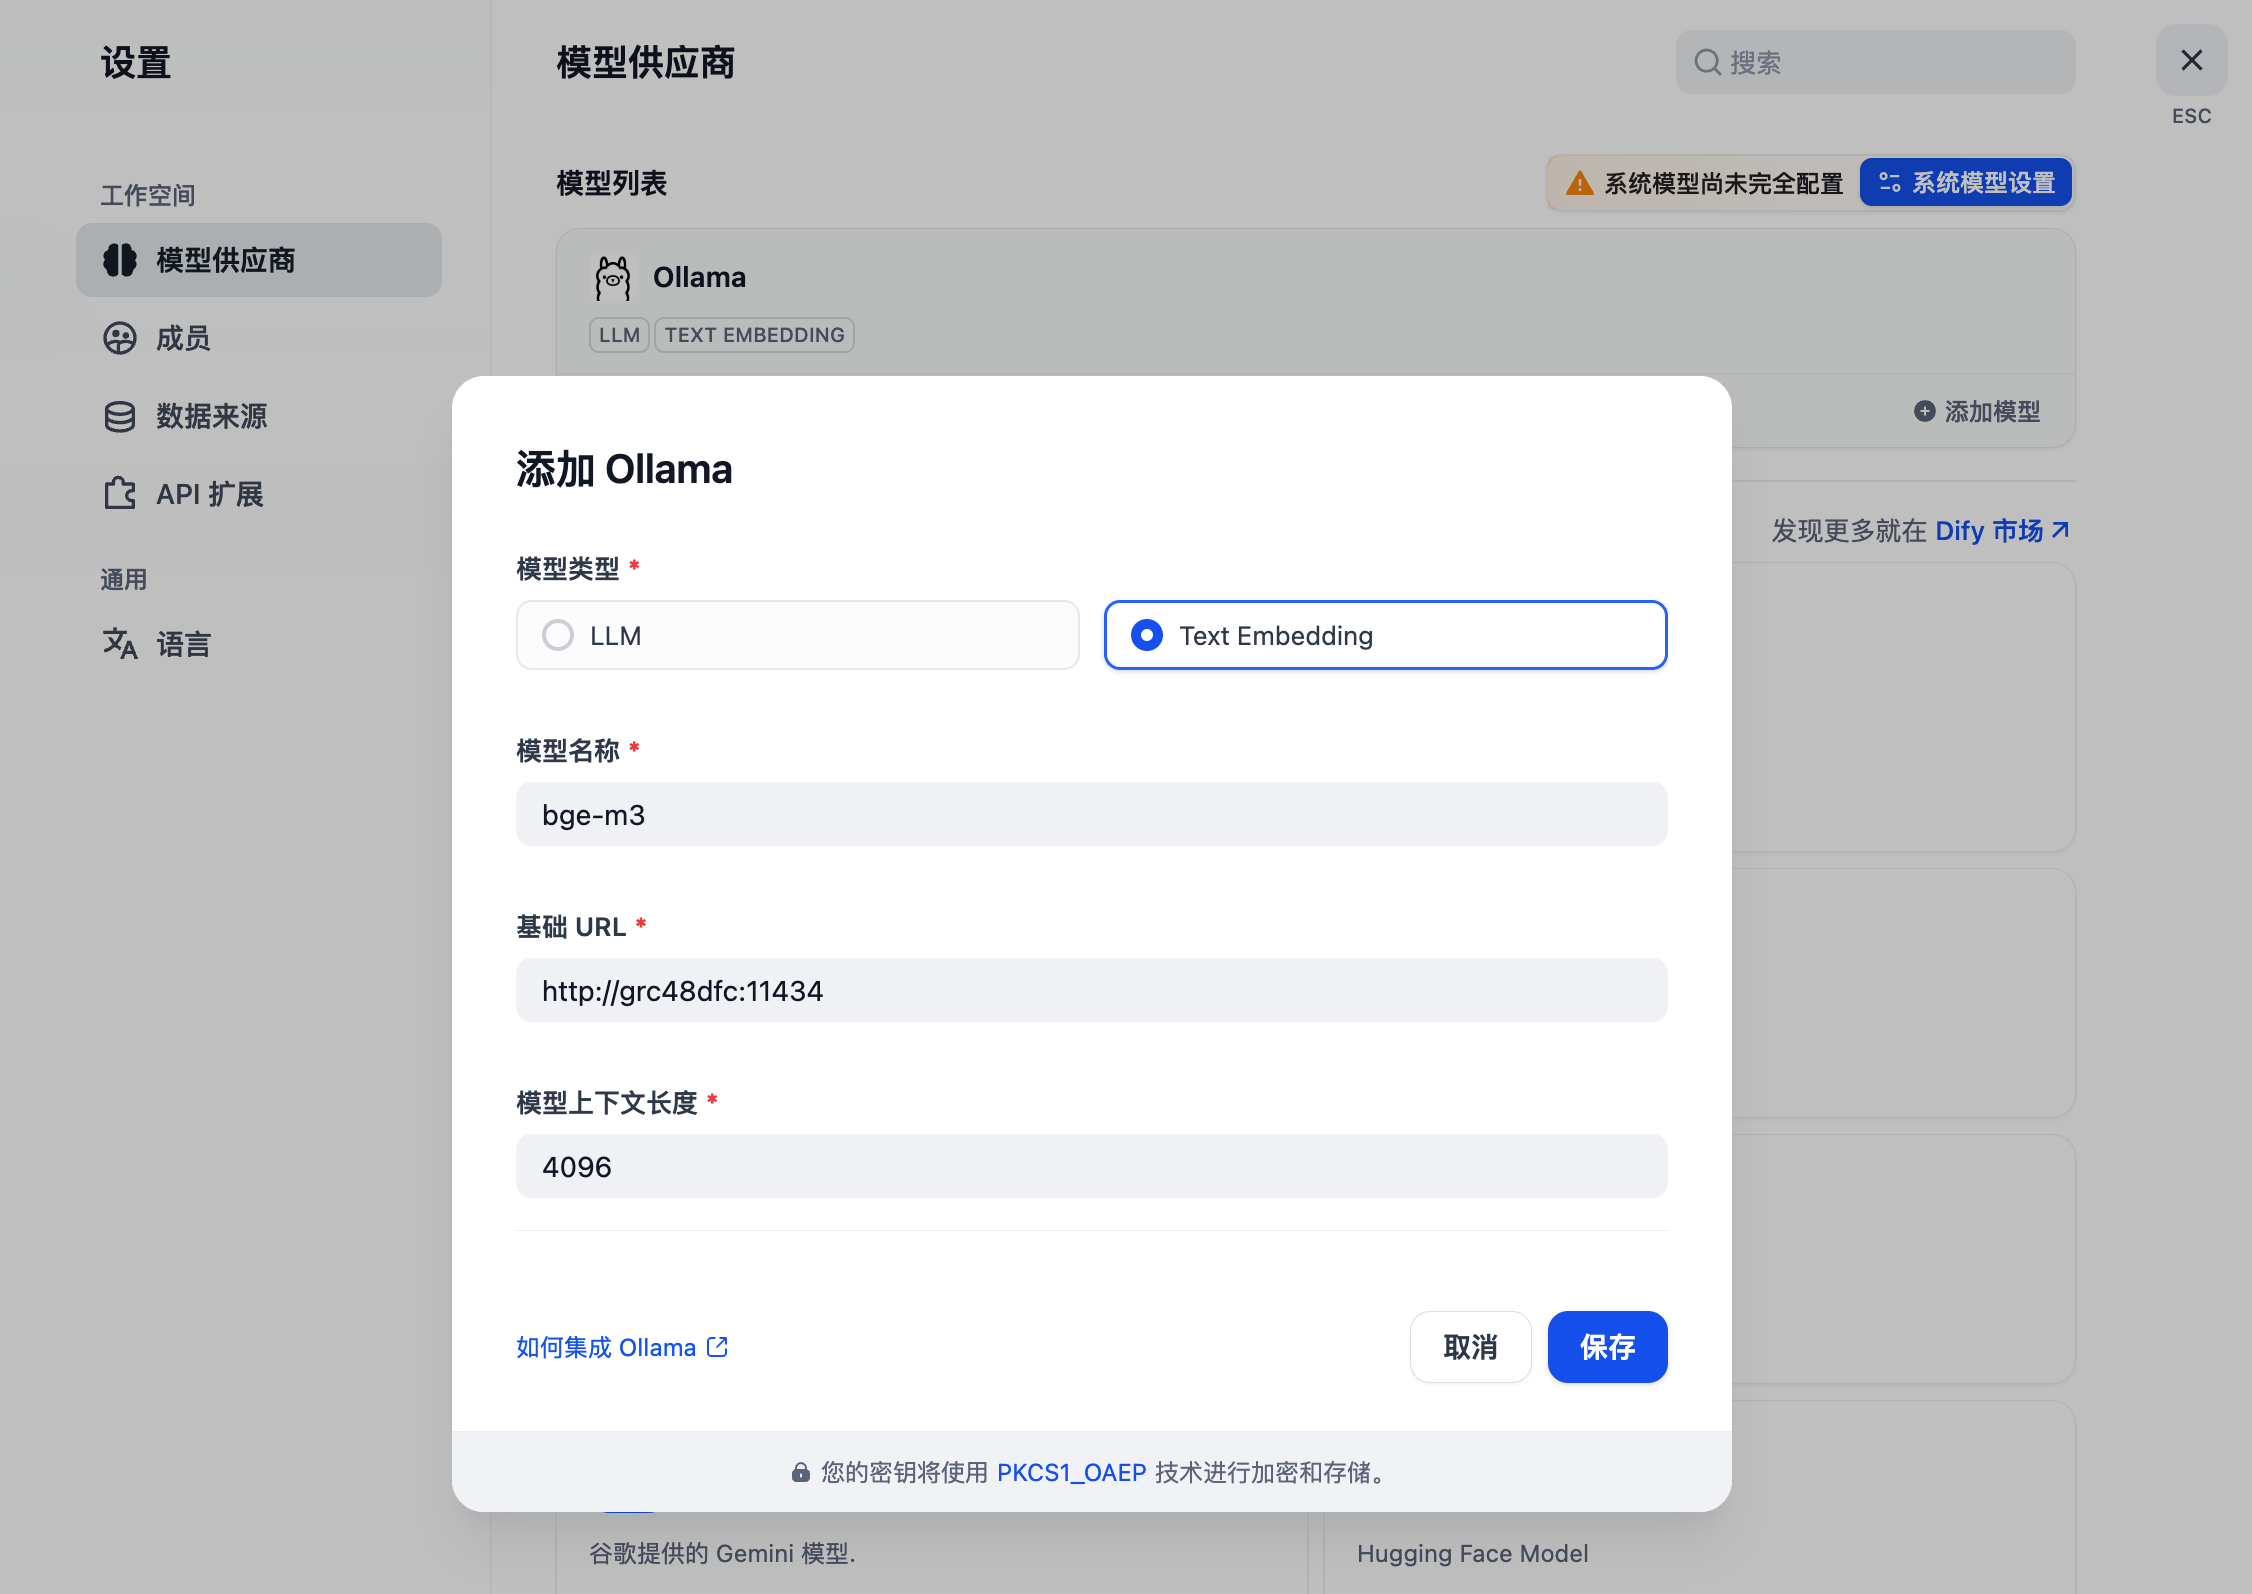
” alt=”Dify本地化部署架构示意”>
三、 精度优化:提升问答准确率的三大关键策略
许多企业在初期PoC(概念验证)阶段常面临回答准确率不足的问题。根据亚马逊云科技的实践案例,初始准确率可能低于30%,但通过以下优化手段可提升至85%以上:
1. 选择更佳的Embedding模型与分块策略
模型的选择直接影响语义理解的深度。BGE-M3不仅支持多语言,还具备长文本处理能力。此外,针对短文章或主题集中的文档,避免过度切分(Chunking),保持文档完整性作为独立数据单元,能显著维持语义连贯性,使召回准确率从55%提升至79%。
2. 引入混合搜索与重排序(Rerank)机制
仅依赖向量相似性检索往往不够精准。最佳实践是采用“混合搜索”:结合基于词频的传统BM25算法和向量检索,扩大召回范围。随后,引入如BGE Re-Ranker v2.0等重排序模型,对召回结果进行二次打分和排序。这一过程能将最终的相关性准确率稳定在85%左右。
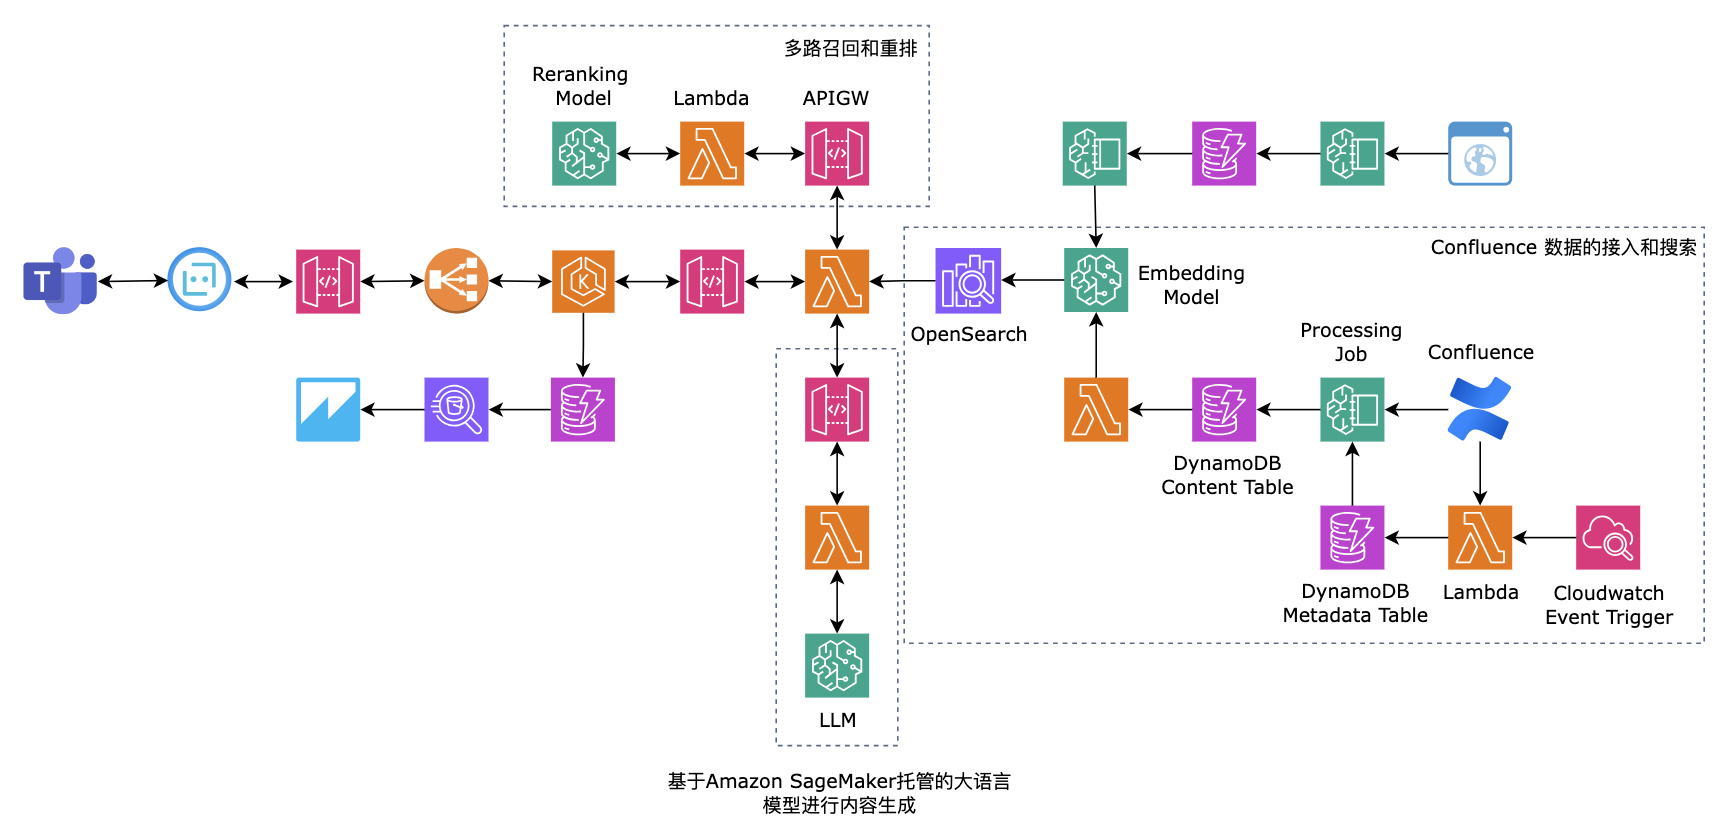
” alt=”混合召回与重排序流程”>
3. 优化大语言模型与提示词工程
在LLM选择上,需权衡参数量、推理速度与成本。Mixtral-8x7B等稀疏混合专家模型在保持高性能的同时降低了推理成本。同时,精心设计的提示词(Prompt)模板能引导模型更严谨地依据“已知信息”作答,减少幻觉现象。
四、 总结与建议
搭建一套安全、高效的企业内部AI问答机器人,不仅是技术的堆叠,更是对数据治理能力的考验。通过选择适合的RAG框架,坚持本地化部署以保护数据隐私,并持续优化Embedding、召回及重排序策略,企业可以将沉睡的私有文档转化为活跃的知识资产。
无论是使用Dify快速上手,还是基于LangChain深度定制,核心目标始终是让AI在安全合规的边界内,真正服务于业务效率的提升。