引言:合同处理的隐私痛点与本地化需求
在企业法务、金融审计及合规审查场景中,PDF合同因其兼容性好、安全性高而成为主流格式。然而,面对大量加密的PDF合同,传统处理方式往往陷入两难:手动解密效率低下,而使用在线AI工具则面临严重的数据泄露风险。如何在不上传云端的情况下本地部署AI工具来批量解析加密的PDF合同并提取关键条款,成为许多技术团队和法务部门亟需解决的难题。
本文将融合开源工具箱、结构化解析引擎及本地大模型技术,构建一套完全离线、安全高效的合同智能处理方案。
第一步:本地化解密与预处理——Stirling-PDF
处理加密合同的首要任务是获取可读内容。商业软件如Adobe Acrobat虽功能强大但需付费激活,而多数在线转换工具存在“先上传后收费”或数据留存隐患。此时,开源项目Stirling-PDF提供了理想的本地化解决方案。
Stirling-PDF是一个功能丰富的本地部署PDF工具箱,支持Docker一键部署。它不仅能合并、分割PDF,更核心的是具备移除密码和OCR扫描功能。对于加密文档,用户可在本地环境中直接去除访问限制;对于扫描件或图片型PDF,通过集成Tesseract OCR引擎(需额外下载中文语言包),可实现高精度的文字识别。
通过Docker Compose部署Stirling-PDF后,所有数据处理均在本地服务器完成,确保敏感合同文件绝不流出内网环境,为后续的AI解析打下安全基础。
第二步:结构化解析——从像素到语义
解密后的PDF若直接扔给大模型,常因布局混乱、表格错位导致“垃圾进,垃圾出”。Docling作为IBM捐赠给Linux基金会的开源工具,专为解决这一问题而生。它不仅是OCR工具,更是生成式AI的文档处理伙伴。
Docling的核心优势在于其深度布局分析能力。它能识别标题、段落、表格、页脚等元素,并将复杂的PDF转换为保留层级结构的Markdown或JSON格式。与传统OCR仅提取文本不同,Docling能理解文档的逻辑结构,例如将多栏文本正确重组,将表格转换为机器可读的格式。更重要的是,Docling默认完全在本地运行,无需云端API,完美契合数据隔离环境的需求。
在处理包含复杂表格和法律脚注的合同时,Docling能确保上下文连贯,大幅减少后续大模型提取条款时的幻觉现象。
第三步:关键条款提取——双链路审阅架构
获得结构化的Markdown文档后,下一步是提取关键法律条款。参考先进的合同审查实践,建议采用“先解析清洗,再分路审阅”的架构,避免将所有任务塞入单个Prompt导致输出混杂。
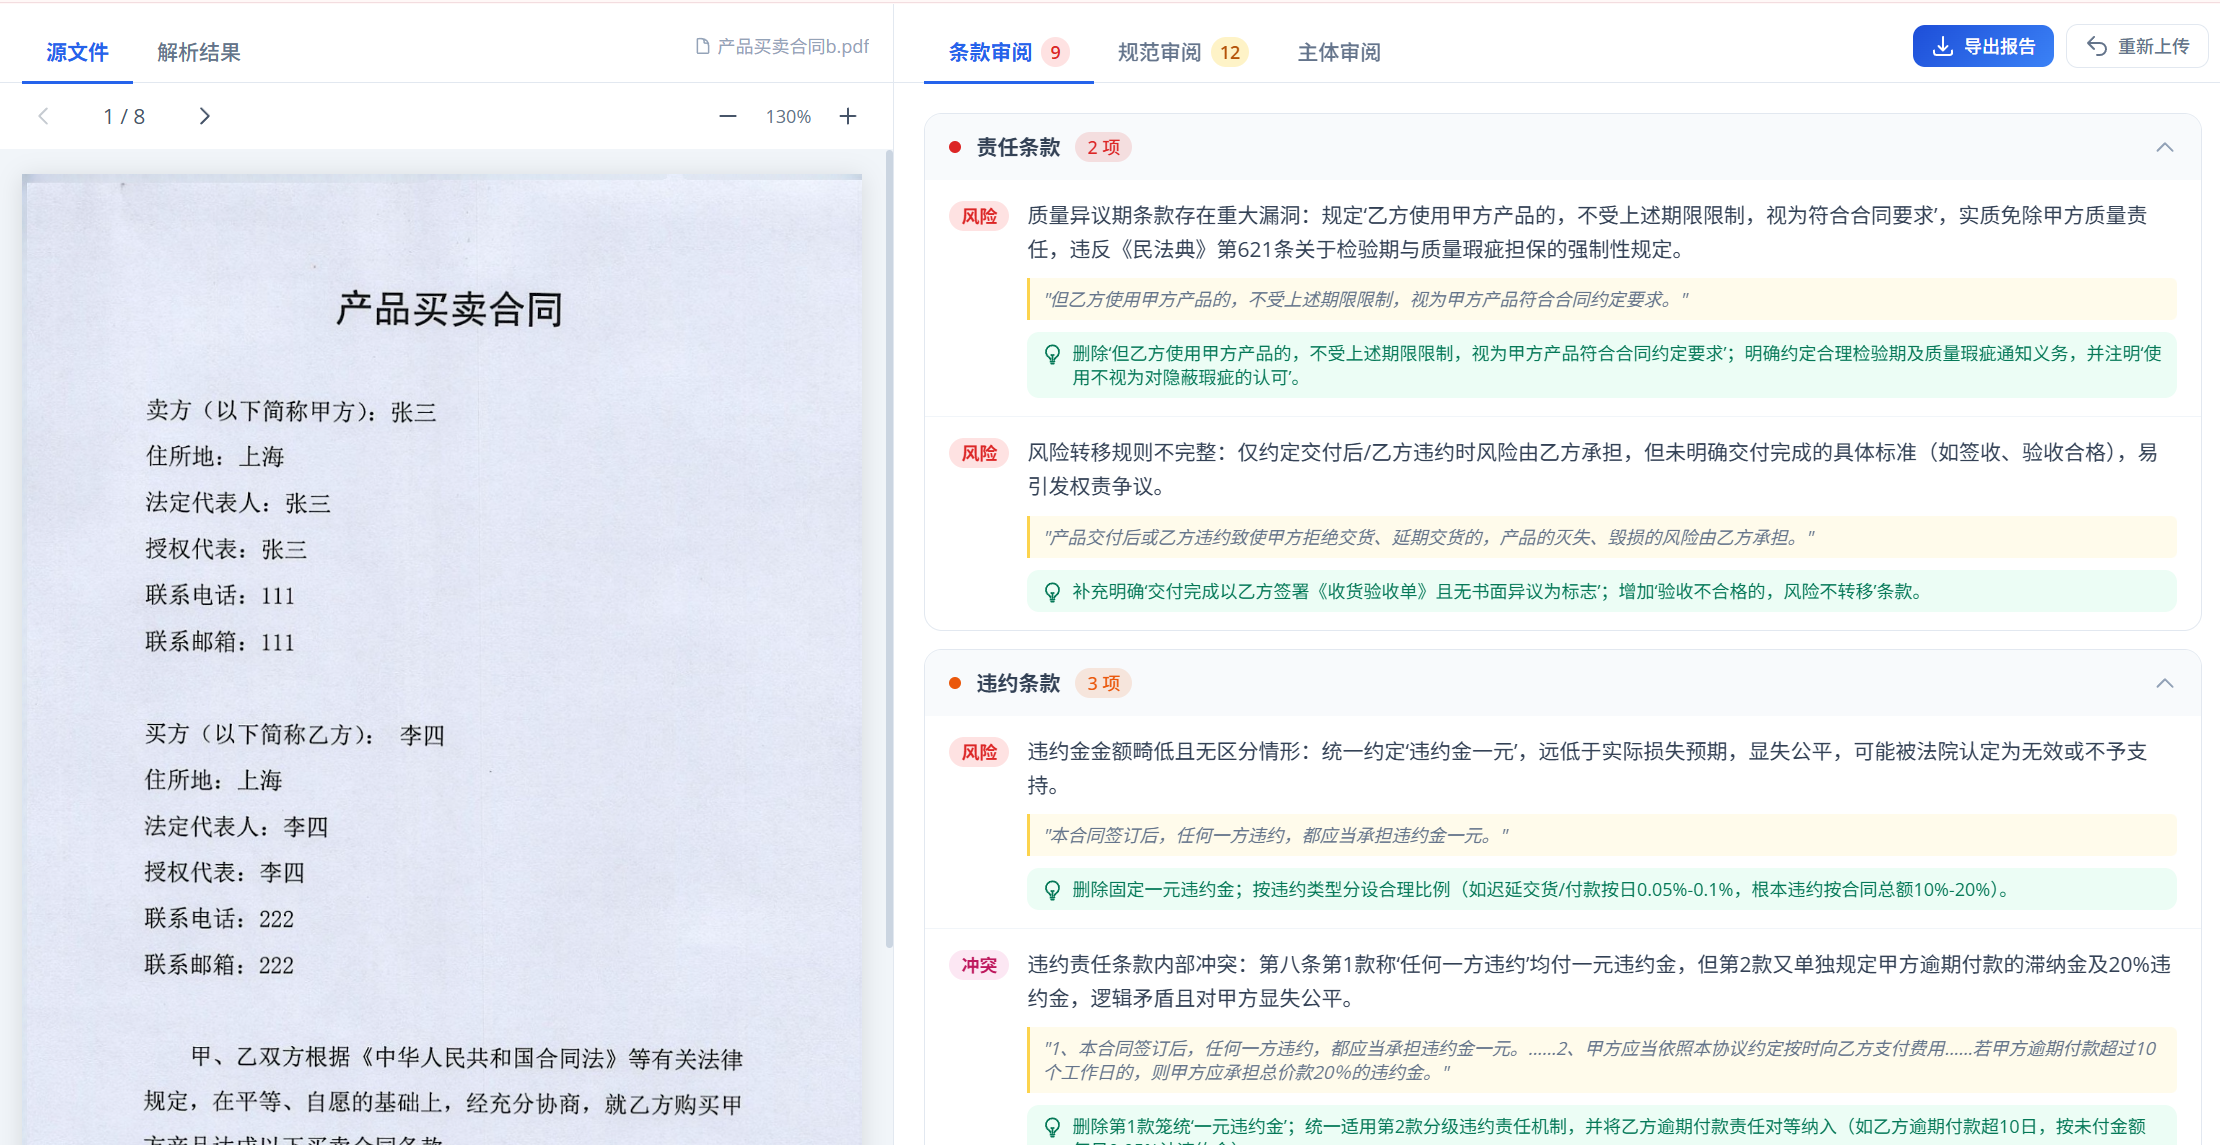
- 解析层统一:无论原始文件是扫描件还是电子档,均通过Docling统一转换为包含页面信息的Markdown中间层。
- 双链路并行:
- 条款风险审阅:针对责任、违约、知识产权等语义风险,设计专用Prompt提取关键原文与建议。
- 规范审阅:针对错漏、一致性、格式等问题进行独立检查。
这种架构确保了输出的结构化JSON既包含法律依据(原文引用),又包含修改建议,且可溯源至具体页码。结合本地部署的大语言模型(如通过Ollama运行的Llama 3或Qwen),整个提取过程无需连接外网,彻底杜绝数据外泄。
第四步:自动化工作流整合
为了实现批量解析,可将上述工具串联为自动化工作流:
- 输入:监控指定文件夹,自动摄入新的加密PDF合同。
- 预处理:调用Stirling-PDF API移除密码,若为扫描件则执行OCR。
- 结构化:调用本地Docling实例,将PDF转换为带布局信息的Markdown。
- 提取:本地LLM读取Markdown,根据预设的法律条款Prompt提取关键信息。
- 输出:生成结构化审查报告(Word/JSON),并归档原始文件。

总结
通过组合Stirling-PDF的本地解密与OCR能力、Docling的高保真结构化解析以及本地大模型的语义理解能力,企业可以构建一套完全自主可控的合同处理系统。这不仅解决了如何在不上传云端的情况下本地部署AI工具来批量解析加密的PDF合同并提取关键条款的技术难题,更在数据安全与处理效率之间找到了最佳平衡点。对于重视数据主权与隐私保护的组织而言,这套开源本地化方案无疑是当前最优的实践路径。