引言:通用大模型的“业务盲区”与安全焦虑
随着大模型在办公场景的普及,许多企业发现通用AI虽然博学,却对内部制度、项目细节和最新政策一无所知。更致命的是,将合同、财报等敏感资料上传至公有云平台,存在极大的数据泄露风险。
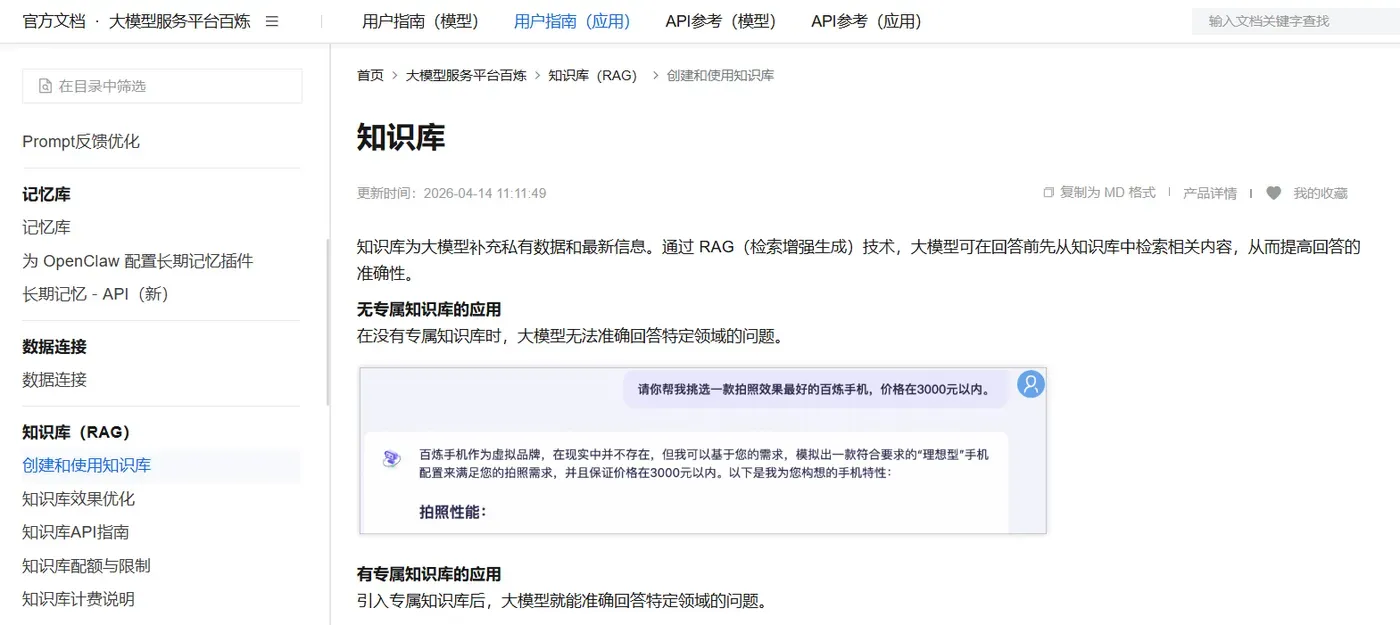
如何在不泄露公司数据的前提下搭建本地部署的企业级知识库助手?答案在于RAG(检索增强生成)技术与本地化部署的结合。通过构建私有向量数据库,让AI在本地读取文档并回答问题,既保留了数据的绝对控制权,又赋予了AI理解专属业务的能力。
核心原理:为什么RAG是私有化最佳解?
RAG架构由“检索”与“生成”两部分组成。其工作流并非让大模型凭空记忆,而是遵循以下闭环:
- 文档处理:将PDF、Word等文件切片、向量化,存入本地向量数据库。
- 语义检索:用户提问时,系统先在库中匹配相关片段。
- 增强生成:将检索到的内容作为上下文喂给本地大模型,生成精准答案。
这种模式从根本上解决了数据隐私、领域专业性不足和信息实时性差三大痛点,特别适合金融、政务及对数据安全要求极高的制造业。
方案一:硬核极客版(Ollama + AnythingLLM)
对于具备一定技术基础或希望完全掌控底层环境的团队,推荐使用开源组合。
1. 硬件与环境准备
本地推理对硬件有一定要求。入门级配置建议CPU 4核、内存16GB;若追求流畅体验,推荐32GB内存搭配NVIDIA显卡(显存6G起步)。软件层面,Windows用户需开启WSL2,或直接使用Docker容器以隔离环境。
2. 部署本地大模型引擎
安装Ollama作为推理后端,拉取针对中文优化的量化模型,如qwen2:7b-q4_0。关键在于向量模型的选择,务必使用支持中文的bge-large-zh,否则会导致检索结果不匹配。
3. 配置知识库管理工具
部署AnythingLLM(桌面版或Docker版),在设置中将LLM提供商指向本地Ollama地址。新建工作区后,拖拽上传公司制度、技术手册等文档,系统会自动完成分块与向量化存储。
方案二:零代码极速版(FlowyAIPC)
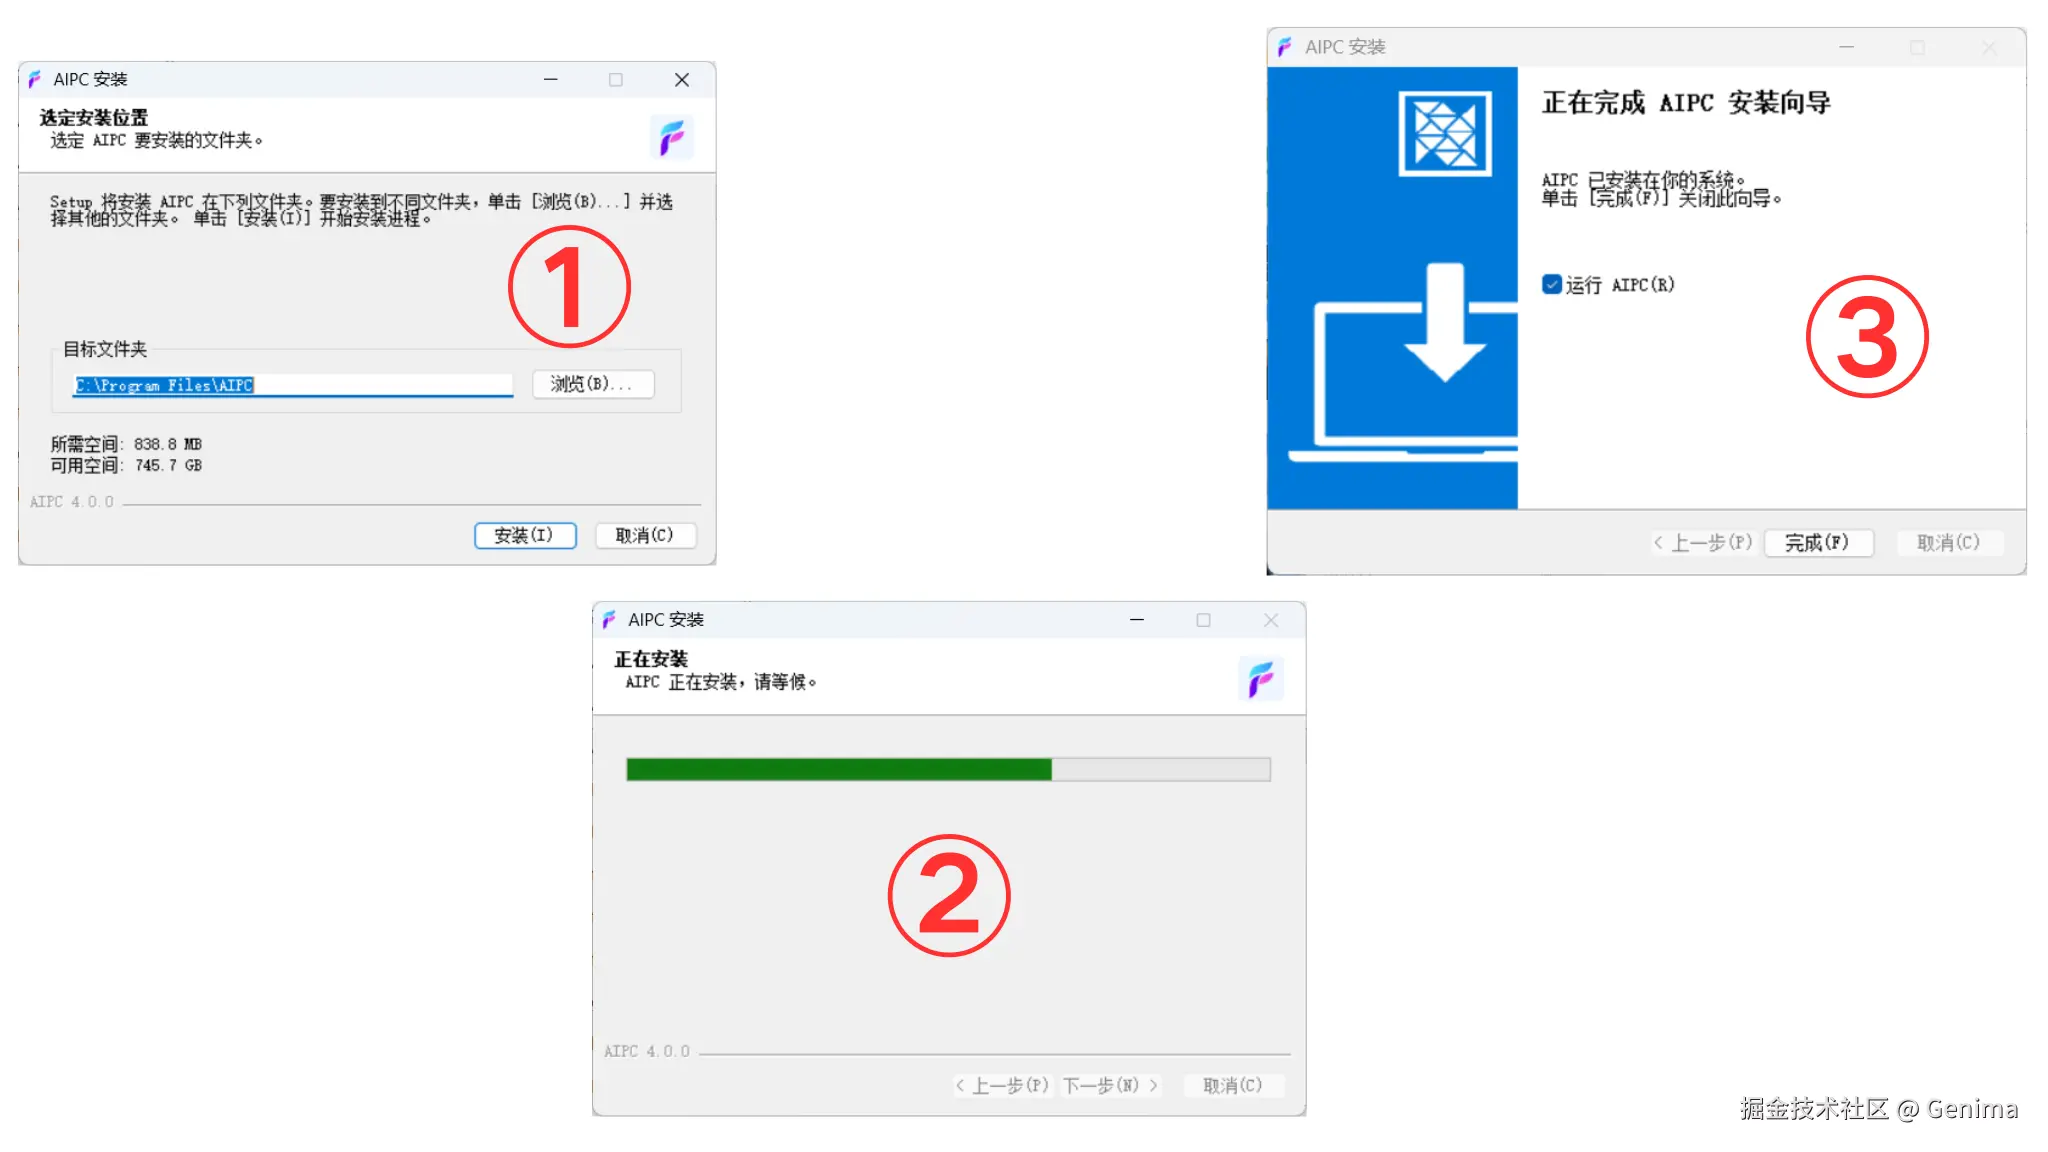
如果团队缺乏开发资源,希望“开箱即用”,FlowyAIPC提供了更友好的图形化界面。
该工具集成了模型下载与管理功能,用户只需下载安装包,进入“模型商店”一键下载Qwen或DeepSeek等本地模型。切换至“本地模型”模式后,所有对话均在离线状态下进行。通过内置的知识库模块,直接上传文件即可实现智能问答,无需编写任何代码或配置服务器。
方案三:云端私有化版(OpenClaw)
对于希望在内网服务器集中管理的团队,可基于腾讯云等基础设施部署OpenClaw。通过安装File Reader和RAG Skills,系统能自动解析Markdown、PDF等格式。其优势在于支持多渠道接入,如飞书、钉钉或Web Dashboard,便于全员协同使用。
避坑指南与效果优化
搭建过程中常见的问题及解决方案如下:
- 检索不准:检查是否使用了英文向量模型处理中文文档;调整Chunk Size(建议500-800字符)和Overlap(100-200字符)以保持语义完整。
- 回答幻觉:在Prompt中强调“仅依据检索内容回答”,并调低模型的Temperature参数。
- 扫描件乱码:图片型PDF需先经OCR工具提取文本后再导入知识库。
- 响应缓慢:启用GPU加速,或更换更小参数的量化模型(如3B版本)。
结语
搭建本地私有知识库不再是高不可攀的技术难题。无论是通过Ollama组合的灵活定制,还是FlowyAIPC的极简体验,企业都能找到适合自身的路径。这不仅保护了核心数据资产,更将沉睡的文档转化为随时可调用的智慧资产,真正实现安全与效率的双赢。