引言:数据隐私与智能化转型的双重挑战
在数字化转型的深水区,企业积累了海量的文档、合同与技术资料,但这些知识往往散落在CRM、OA或个人电脑中,形成严重的“信息孤岛”。与此同时,通用公有大模型虽然强大,却因无法获取企业内部专属数据而显得“不接地气”,更关键的是,将核心经营数据上传至第三方云平台存在巨大的数据隐私安全风险。
如何在享受AI红利的同时,确保核心数据绝对可控?如何搭建基于本地大模型的企业内部知识库以保障数据隐私安全,已成为金融、制造、政务等高合规要求行业的首要课题。本文将结合最新技术实践与市场测评,为您提供一套从原理到落地的完整解决方案。
一、为什么必须选择“本地私有化”部署?
传统SaaS知识库虽便捷,但在面对严格的数据主权要求时往往力不从心。本地私有化部署的核心价值在于:
- 数据主权完全可控:所有文档、向量数据及问答日志均存储在企业内网服务器或本地终端,从物理层面切断数据外泄风险,满足等保2.0及GDPR等合规要求。
- 领域知识深度适配:通过导入内部制度、行业白皮书,让大模型学习专属业务逻辑,避免通用模型回答宽泛空洞的问题。
- 实时动态更新:新产品政策、临时通知可随时入库,摆脱大模型训练数据的时间滞后性。
二、核心技术架构:RAG检索增强生成
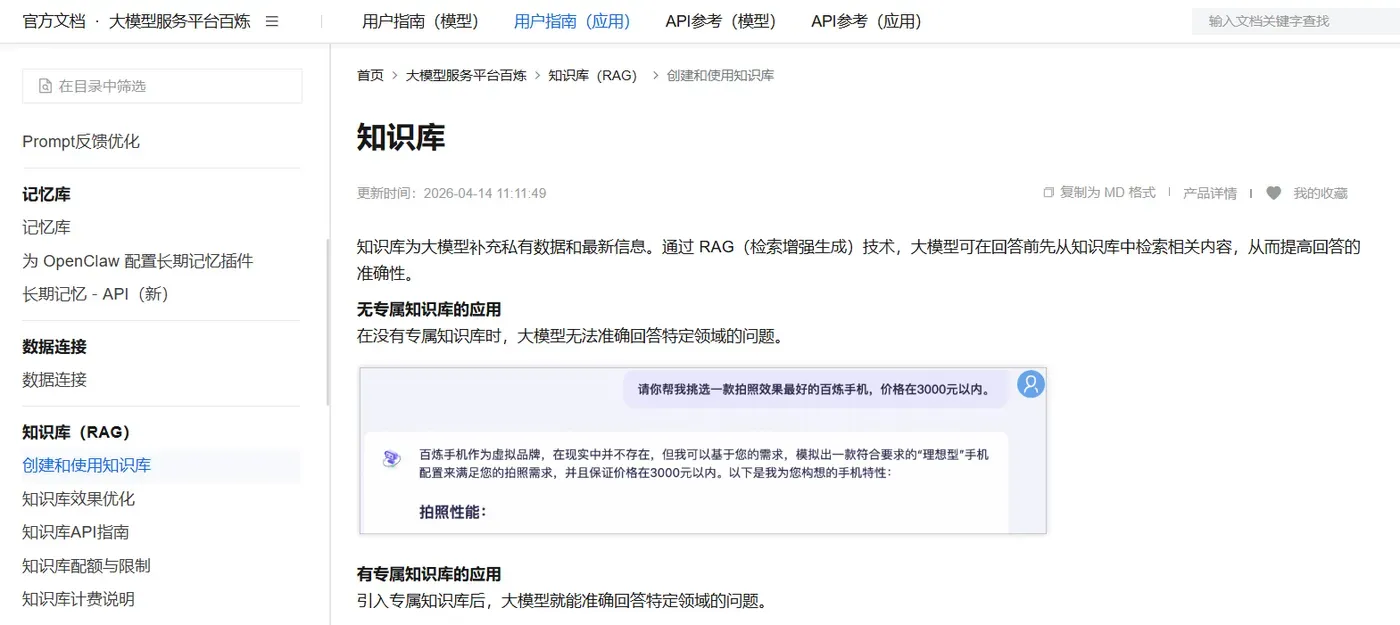
解决大模型“幻觉”与“知识缺失”的最佳方案是RAG(Retrieval-Augmented Generation)。其工作流形成一个标准化闭环:
- 文档处理:系统自动解析PDF、Word、Excel等非结构化文档,进行文本清洗与智能分块。
- 向量化存储:利用嵌入模型(Embedding Model)将文本转化为向量,存入本地向量数据库(如LanceDB、Chroma)。
- 语义检索:用户提问时,系统先在向量库中检索最相关的知识片段。
- 增强生成:将检索到的上下文作为参考,交给本地大模型生成精准答案,并附带来源溯源。
这种架构既保留了大模型的逻辑推理能力,又确保了回答基于企业真实数据,实现了安全性与准确性的平衡。
三、方案选型:开源框架 vs 商业平台
根据企业技术实力与预算,目前主流路径分为两类:
1. 开源轻量级方案(适合技术团队/中小企业)
以Ollama + AnythingLLM/Dify/RAGFlow为代表。Ollama提供了极简的本地大模型运行引擎,支持Qwen2、Llama3等主流模型的一键拉取与量化运行。AnythingLLM则提供了友好的桌面端界面,支持拖拽上传文档,适合快速概念验证(POC)。
- 优势:零成本、高度可定制、完全离线可用。
- 劣势:需自行维护底层环境,复杂文档(如扫描件、复杂表格)解析能力依赖额外OCR组件。
2. 企业级商业平台(适合大型集团/强合规场景)
如数商云、LumeValley、达观数据等。这类平台在私有化部署方面更为成熟,支持信创环境适配(鲲鹏/飞腾芯片)、细粒度权限管控(RBAC)、全链路审计日志及国密加密。
- 优势:开箱即用、支持复杂文档高精度解析、提供源码交付与专业运维支持。
- 劣势:初期投入较高,需评估厂商是否真正支持“纯内网离线”运行,避免伪私有化陷阱。
四、手把手搭建:从零构建本地知识库
若选择开源路径,以下是最简化的实施步骤:
第一步:环境准备与模型安装
推荐使用配置较高的本地PC或内网服务器(建议32GB+内存,NVIDIA显卡可选)。安装Ollama后,拉取对中文支持友好的量化模型,如qwen2:7b-q4_0。同时,务必拉取中文专用的向量模型bge-large-zh,这是确保中文检索准确率的关键。
第二步:部署知识库管理工具
下载AnythingLLM桌面版或通过Docker部署。在初始化设置中,选择“Local本地部署”,跳过云端API密钥。在LLM提供商中选择Ollama,地址指向本地服务;在Embedding提供商中同样选择Ollama并指定bge-large-zh模型。
第三步:参数优化与文档导入
调整文本分块参数(Chunk Size建议500-800字符,Overlap建议100-200字符),以避免长文本语义断裂。上传PDF、Word等文档后,系统会自动完成切片与向量化。对于扫描版PDF,建议先通过OCR工具提取文字后再导入,以提升解析效果。
五、避坑指南与效果优化
在实际落地中,常见问题及解决方案如下:
- 检索不匹配:检查是否使用了英文向量模型处理中文文档,务必更换为中文专用模型;适当增加分块重叠长度。
- 回答胡编乱造:调低大模型的Temperature参数(如设为0.3),并在提示词中强制要求“仅依据提供的上下文回答”。
- 响应速度慢:使用4bit量化模型降低显存占用;开启GPU加速;对于海量文档,可引入重排序(Rerank)机制提升检索精度而非盲目增加检索数量。
- 伪私有化风险:选型时需验证系统在断网环境下是否能完整运行,确认无隐性云端依赖组件。
结语
搭建基于本地大模型的企业内部知识库,不仅是技术的升级,更是企业知识资产管理模式的变革。通过合理的架构设计与选型,企业可以在确保数据隐私安全的前提下,激活沉睡的知识资产,提升员工效率与决策质量。建议企业采取“小步快跑”策略,先从高频刚需场景切入,逐步完善知识体系,最终实现智能化的知识生态闭环。