引言:通用大模型的“盲区”与企业知识的“孤岛”
在AI赋能企业的浪潮中,许多团队面临一个尴尬现状:通用大模型虽然强大,却对企业的核心技术方案、项目复盘、操作手册等“隐性知识”一无所知。这些散落在Wiki、PDF和各类文档中的内容,才是企业的核心竞争力。
然而,直接将内部文档上传至公有云API存在极大的数据泄露风险。因此,如何基于企业内部Wiki和文档构建私有化部署的AI问答助手以保障数据隐私,成为IT负责人和技术管理者必须解决的关键课题。
一、 为什么必须选择本地私有化部署?
在搭建知识库前,首要决策是路线选择。对于涉及机密资料的企业,公有云方案存在不可忽视的安全隐患:
- 传输与存储风险:数据经过公网、云平台网关及服务器,可能在日志或显存中残留,甚至被用于模型微调训练,导致敏感信息泄露。
- 合规红线:《数据安全法》与《个人信息保护法》要求重要数据境内存储且拥有完全控制权。私有化部署能确保数据不出企业大门,满足等保2.0及行业合规要求。
正确做法是采用本地私有化部署,将文档存储于内网服务器,使用开源大模型(如Qwen2.5)进行本地推理,实现物理隔离与自主权限管理。
二、 核心架构:从文档解析到RAG检索
构建一个可用的企业AI知识库,需要打通以下核心组件:
- 文档解析引擎:需支持Word、Excel、PDF及音视频格式。重点解决表格、公式及图片OCR的解析难题,保留多级标题层级结构。
- 向量数据库:将文本转化为向量存储。小规模可选FAISS,中大规模推荐Milvus或Qdrant。
- RAG检索框架:连接检索与生成的桥梁。通过LangChain或LlamaIndex实现“先检索相关片段,再让模型生成答案”的逻辑。
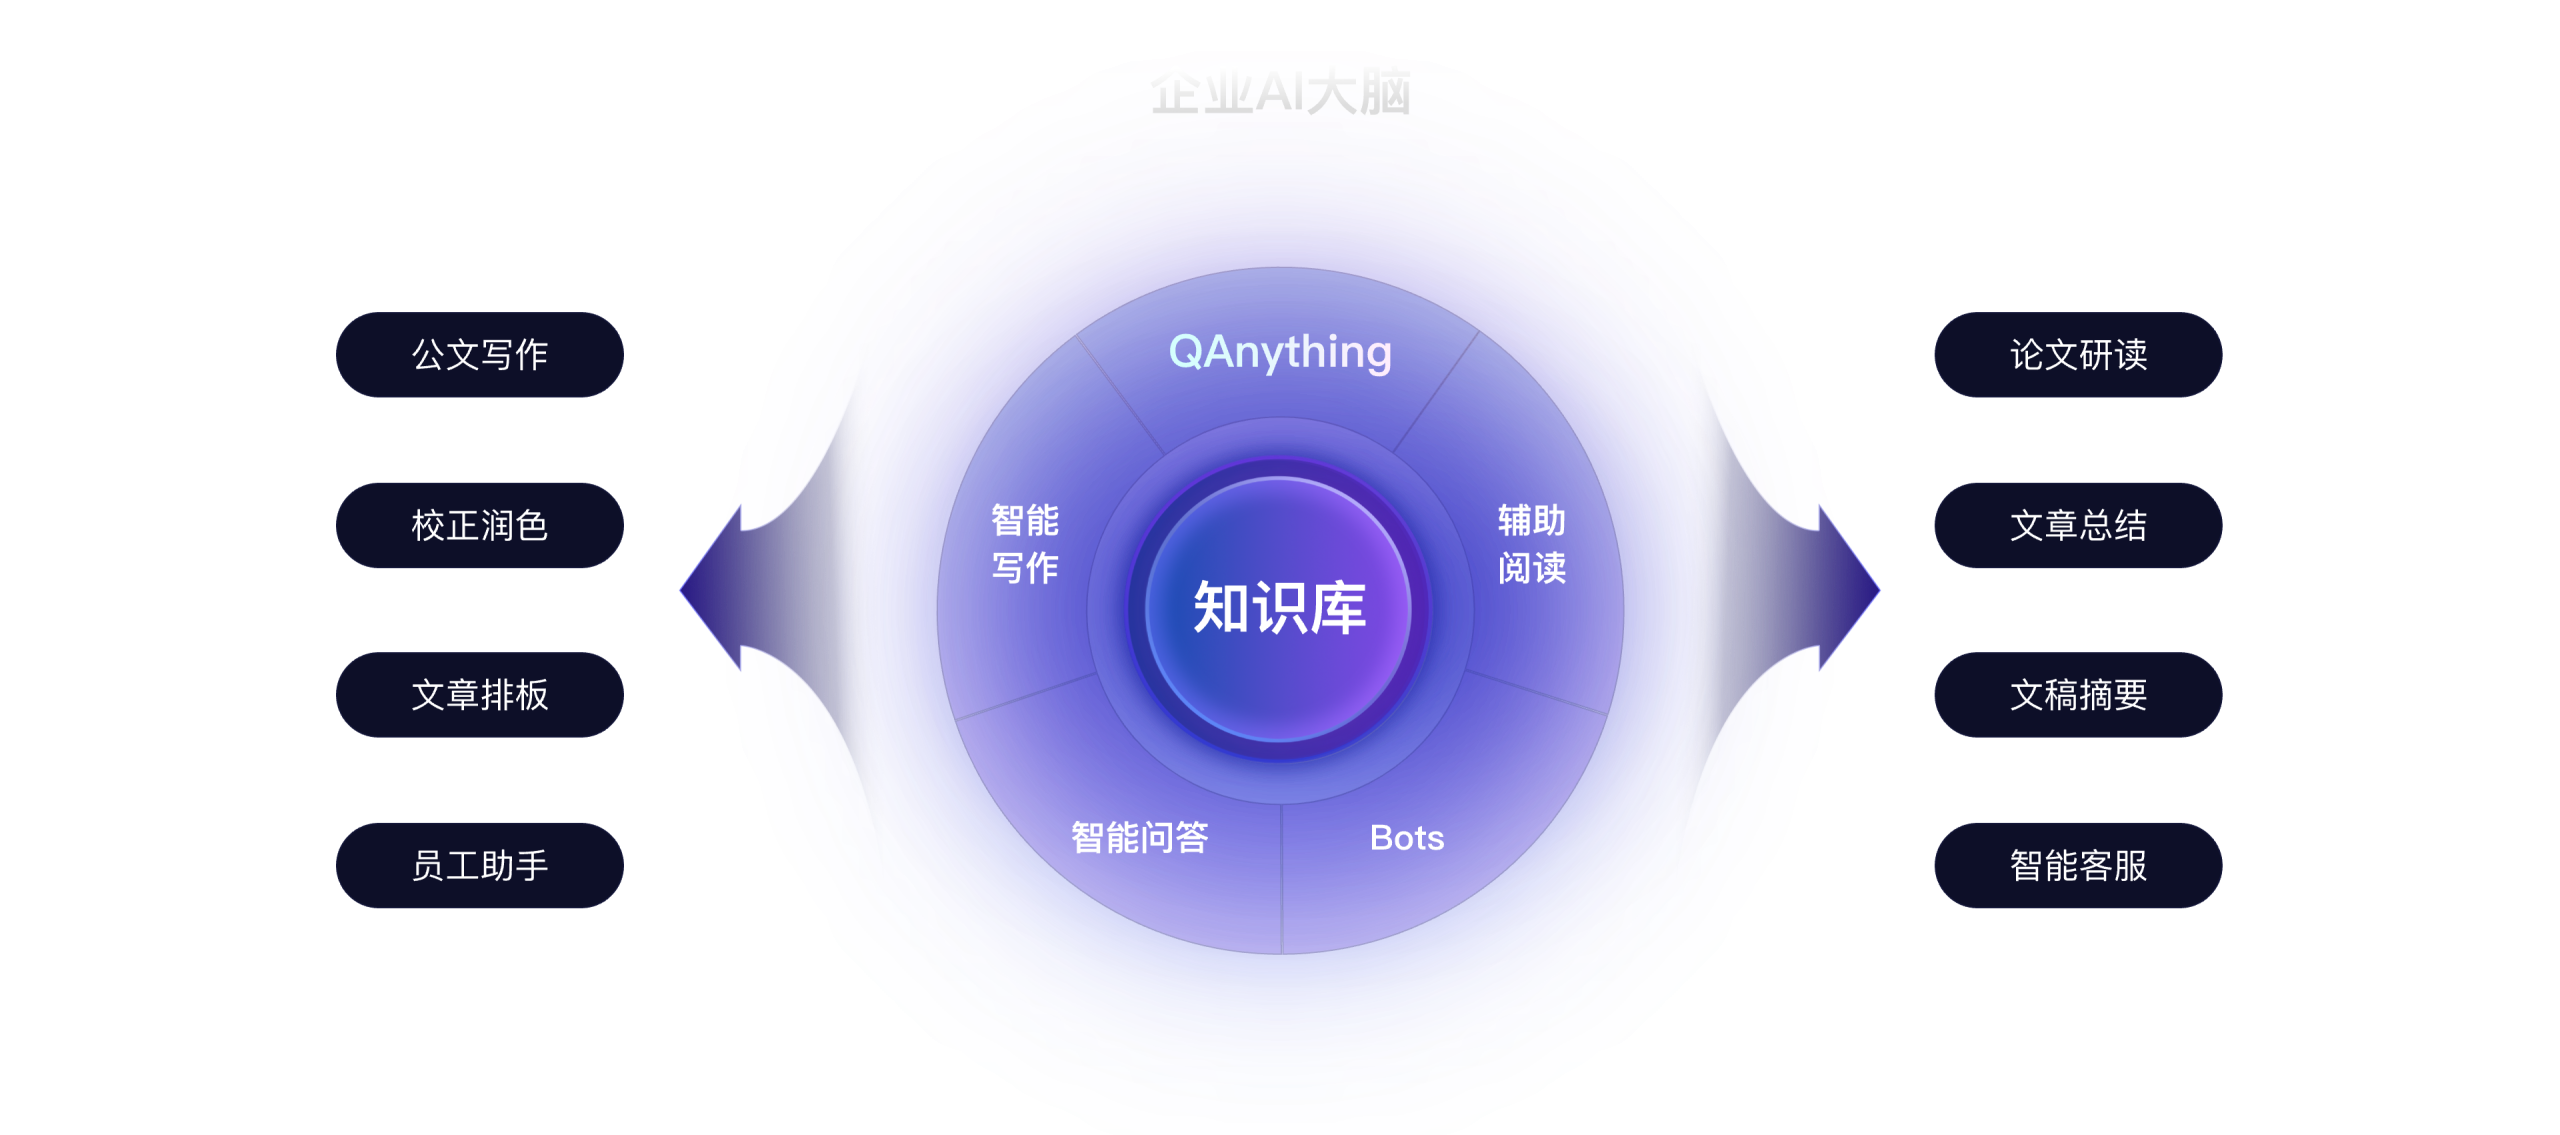
” alt=”企业级本地知识库架构示意”>
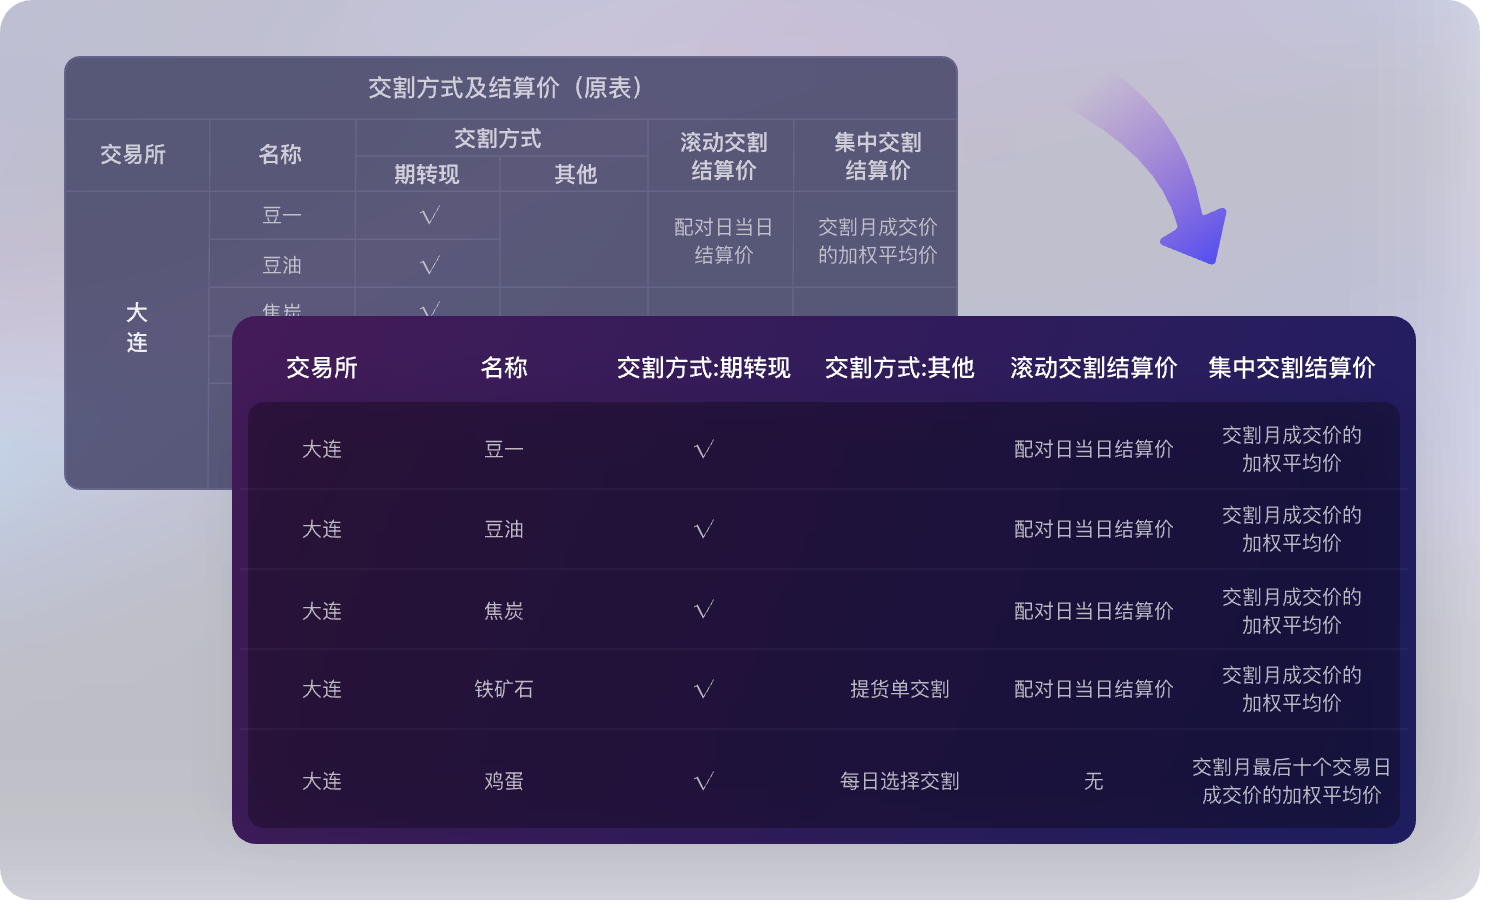
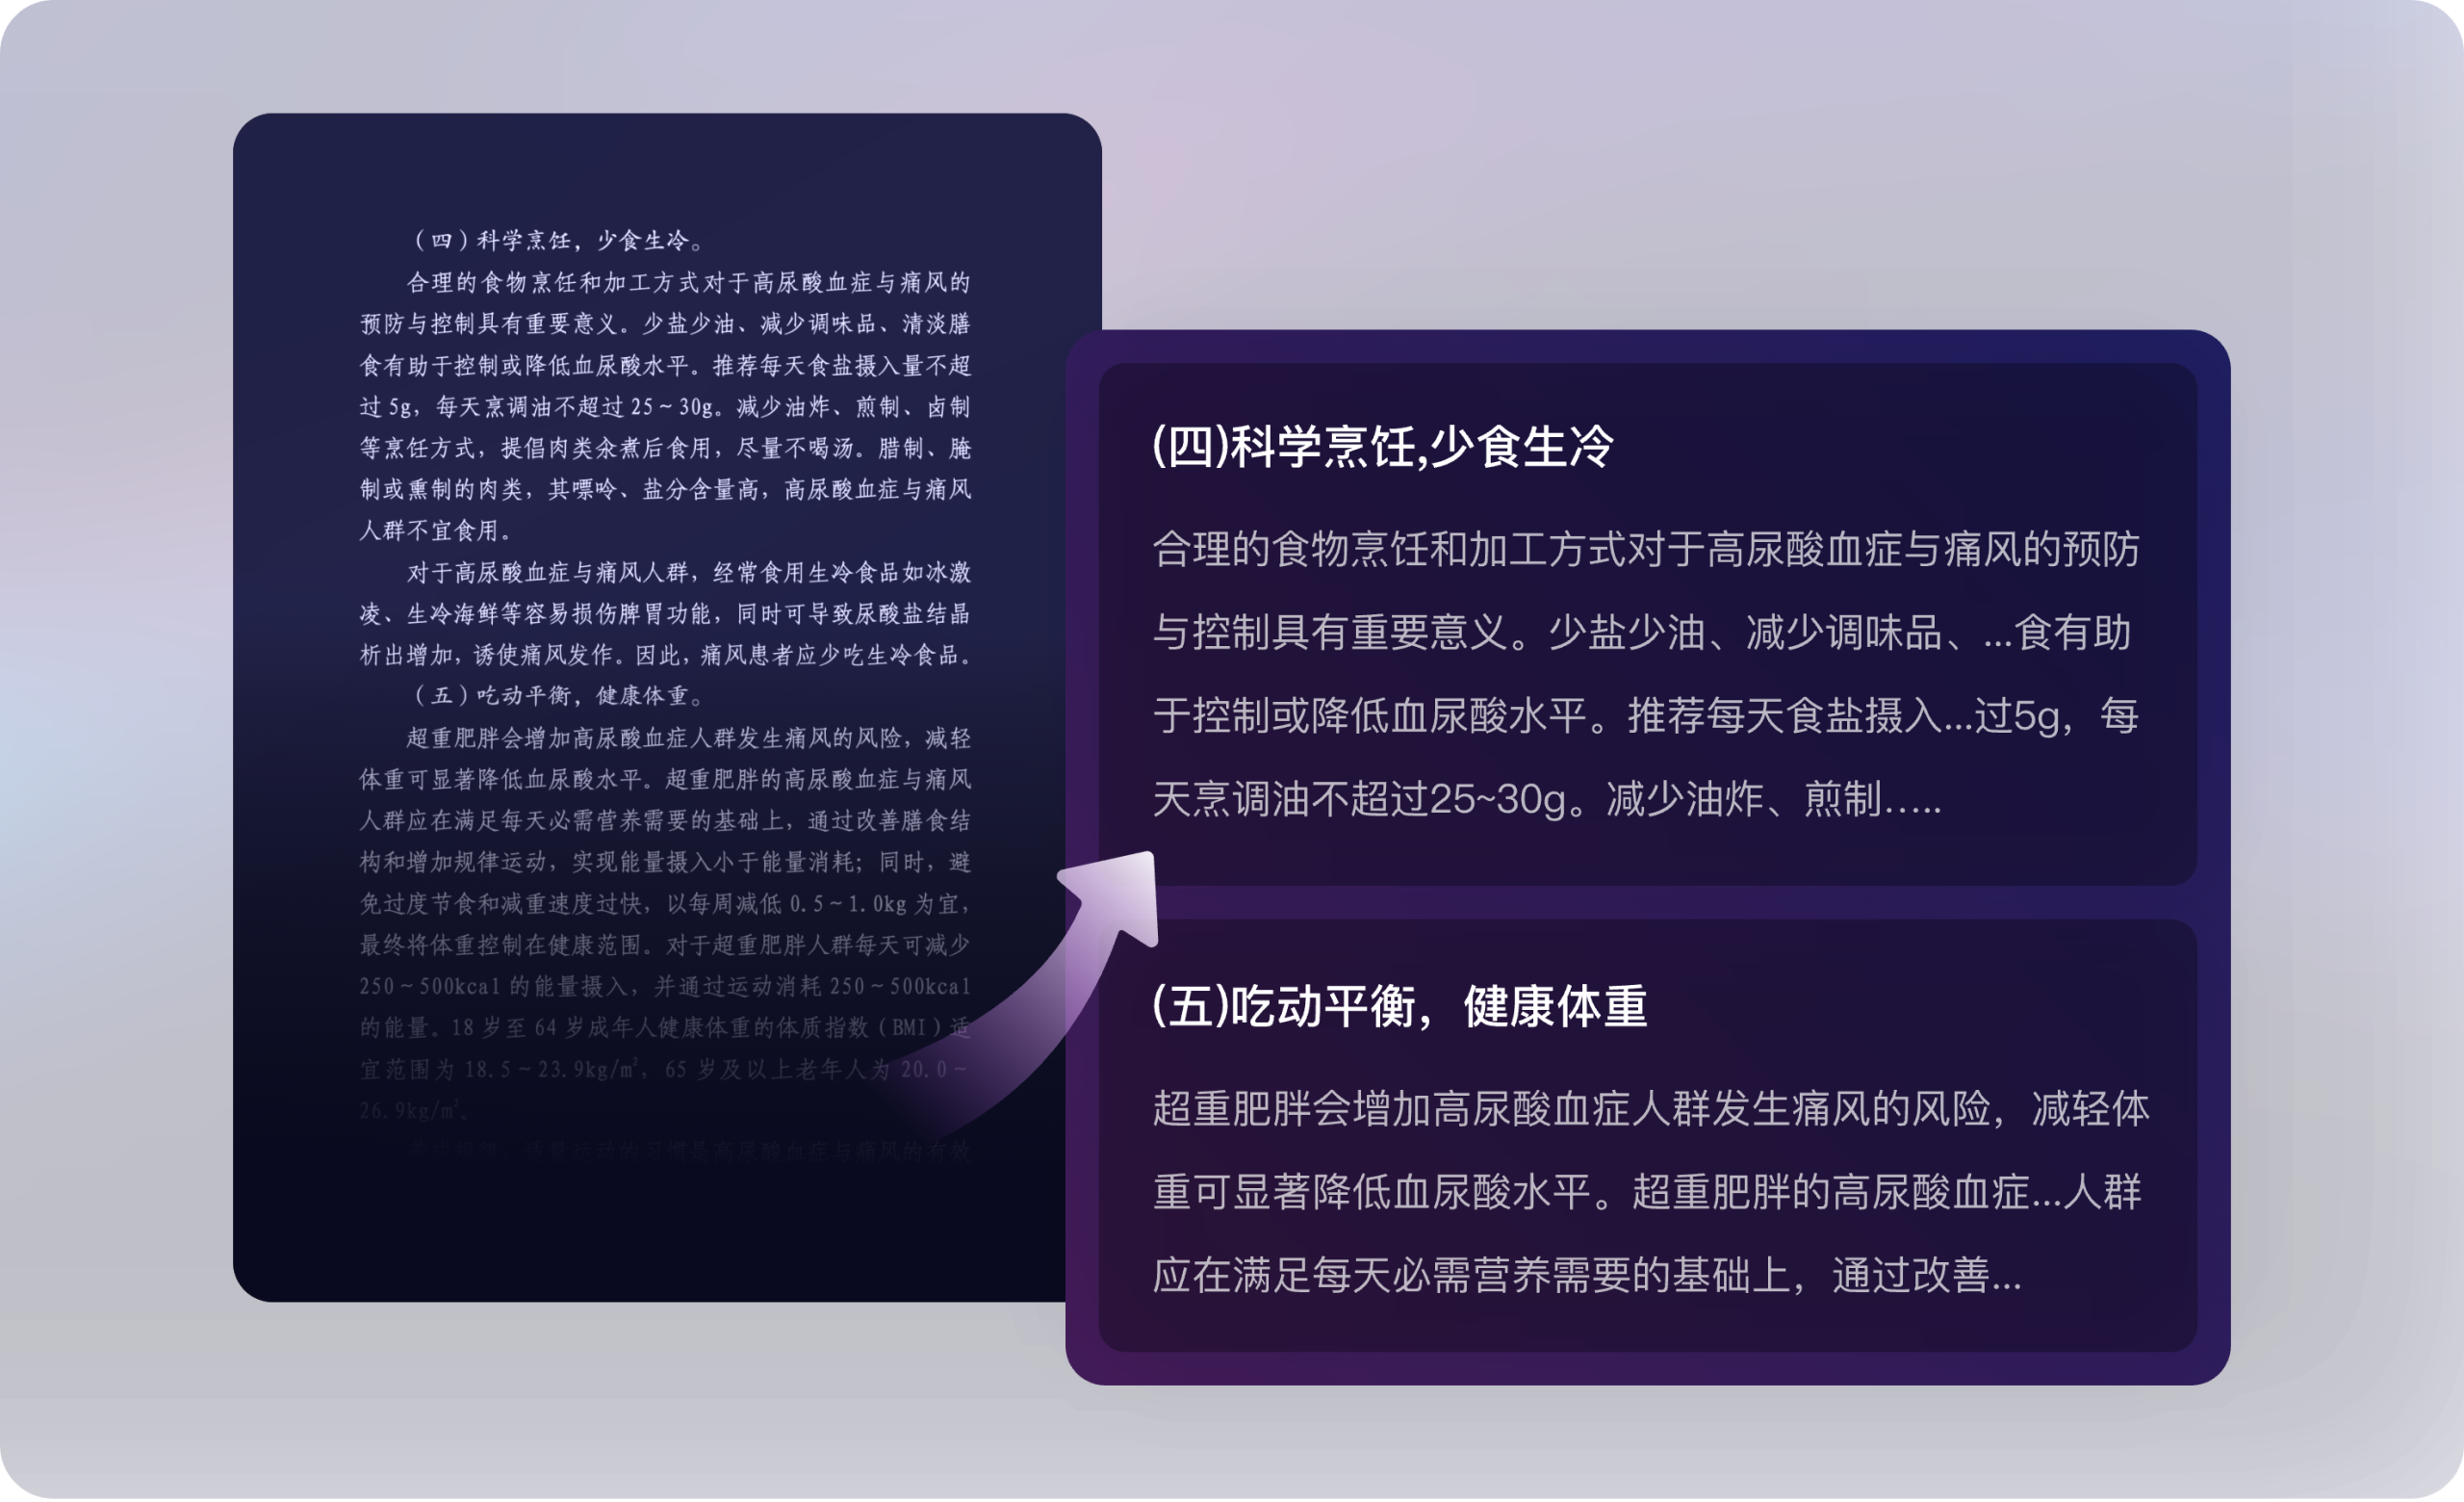
值得注意的是,优质的解析是基础。例如网易有道的QAnything系统,针对docx、pptx、pdf进行了特别优化,能准确解析其中的表格和图片,并确保切片包含完整的语义单元,这为后续的精准问答打下了坚实基础。
三、 避坑指南:RAG优化与Embedding陷阱
在实践过程中,直接全量导入文档会导致Token消耗巨大且上下文溢出。引入RAG(检索增强生成)后,需注意以下调优细节:
1. 切分策略的选择
实验表明,基于Markdown语义的切分通常优于纯文本长度切分,因为它能避免将子标题与内容强行分割。但切片过大可能导致相似度匹配不准,过小则信息量不足。建议按段落自然边界切分,并保留10-20%的重叠。
2. 警惕Embedding的“语义失真”
Embedding将文本转为向量计算相似度,但在IT专业领域,不同表述的语义距离可能较远。例如,“怎么优化数据库”与“SQL调优方案”在向量空间中可能不够接近。此时,混合检索(语义检索+关键词检索)能显著提升召回率。
3. Re-ranking重排序
在初步检索出Top 10-20个片段后,引入Re-ranking模型进行二次排序,能有效弥补Embedding在长尾问题上的短板,提升“第一条即正确答案”的概率。
四、 质量管控:建立企业专属Benchmark
很多团队急于导入数据,却忽略了效果评估。SmartX研发团队的实践建议:先建立企业自己的Benchmark(基准测试)。
- 构建测试集:选取内部培训试卷或典型业务问答,将其结构化。
- 裸考对比:先让模型在无知识库情况下作答,确立基线分数。
- 迭代验证:导入知识库后再次测试。若分数未显著提升,往往不是模型问题,而是数据准确性或文档版本过时导致的。
通过Debug模式分析错题,有时会发现AI的回答比标准答案更严谨(如考虑了特定白名单场景)。此时应修正的是题库或文档表述,而非盲目调整算法。
” alt=”知识库问答效果对比”>
五、 安全最后一道防线:权限与审计
技术架构之外,管理制度同样关键:
- 分级权限:根据文档机密等级(公开/内部/机密)设置访问范围,支持部门级隔离。
- 审计追踪:记录谁在何时查询了什么内容,对异常批量下载行为实时告警。
- 定期清理:每季度审计权限,及时移除离职人员访问权,清理过期文档。
总结
构建企业私有化AI问答助手,本质是“安全优先、数据为王、持续迭代”的过程。通过本地部署保障数据隐私,利用高质量的文档解析与混合检索提升回答准确率,并借助Benchmark持续优化知识质量。只有这样,才能真正盘活企业内部知识资产,让AI成为员工得力的业务助手。
” alt=”私有化部署安全架构”>