引言:财务数据上云的“达摩克利斯之剑”
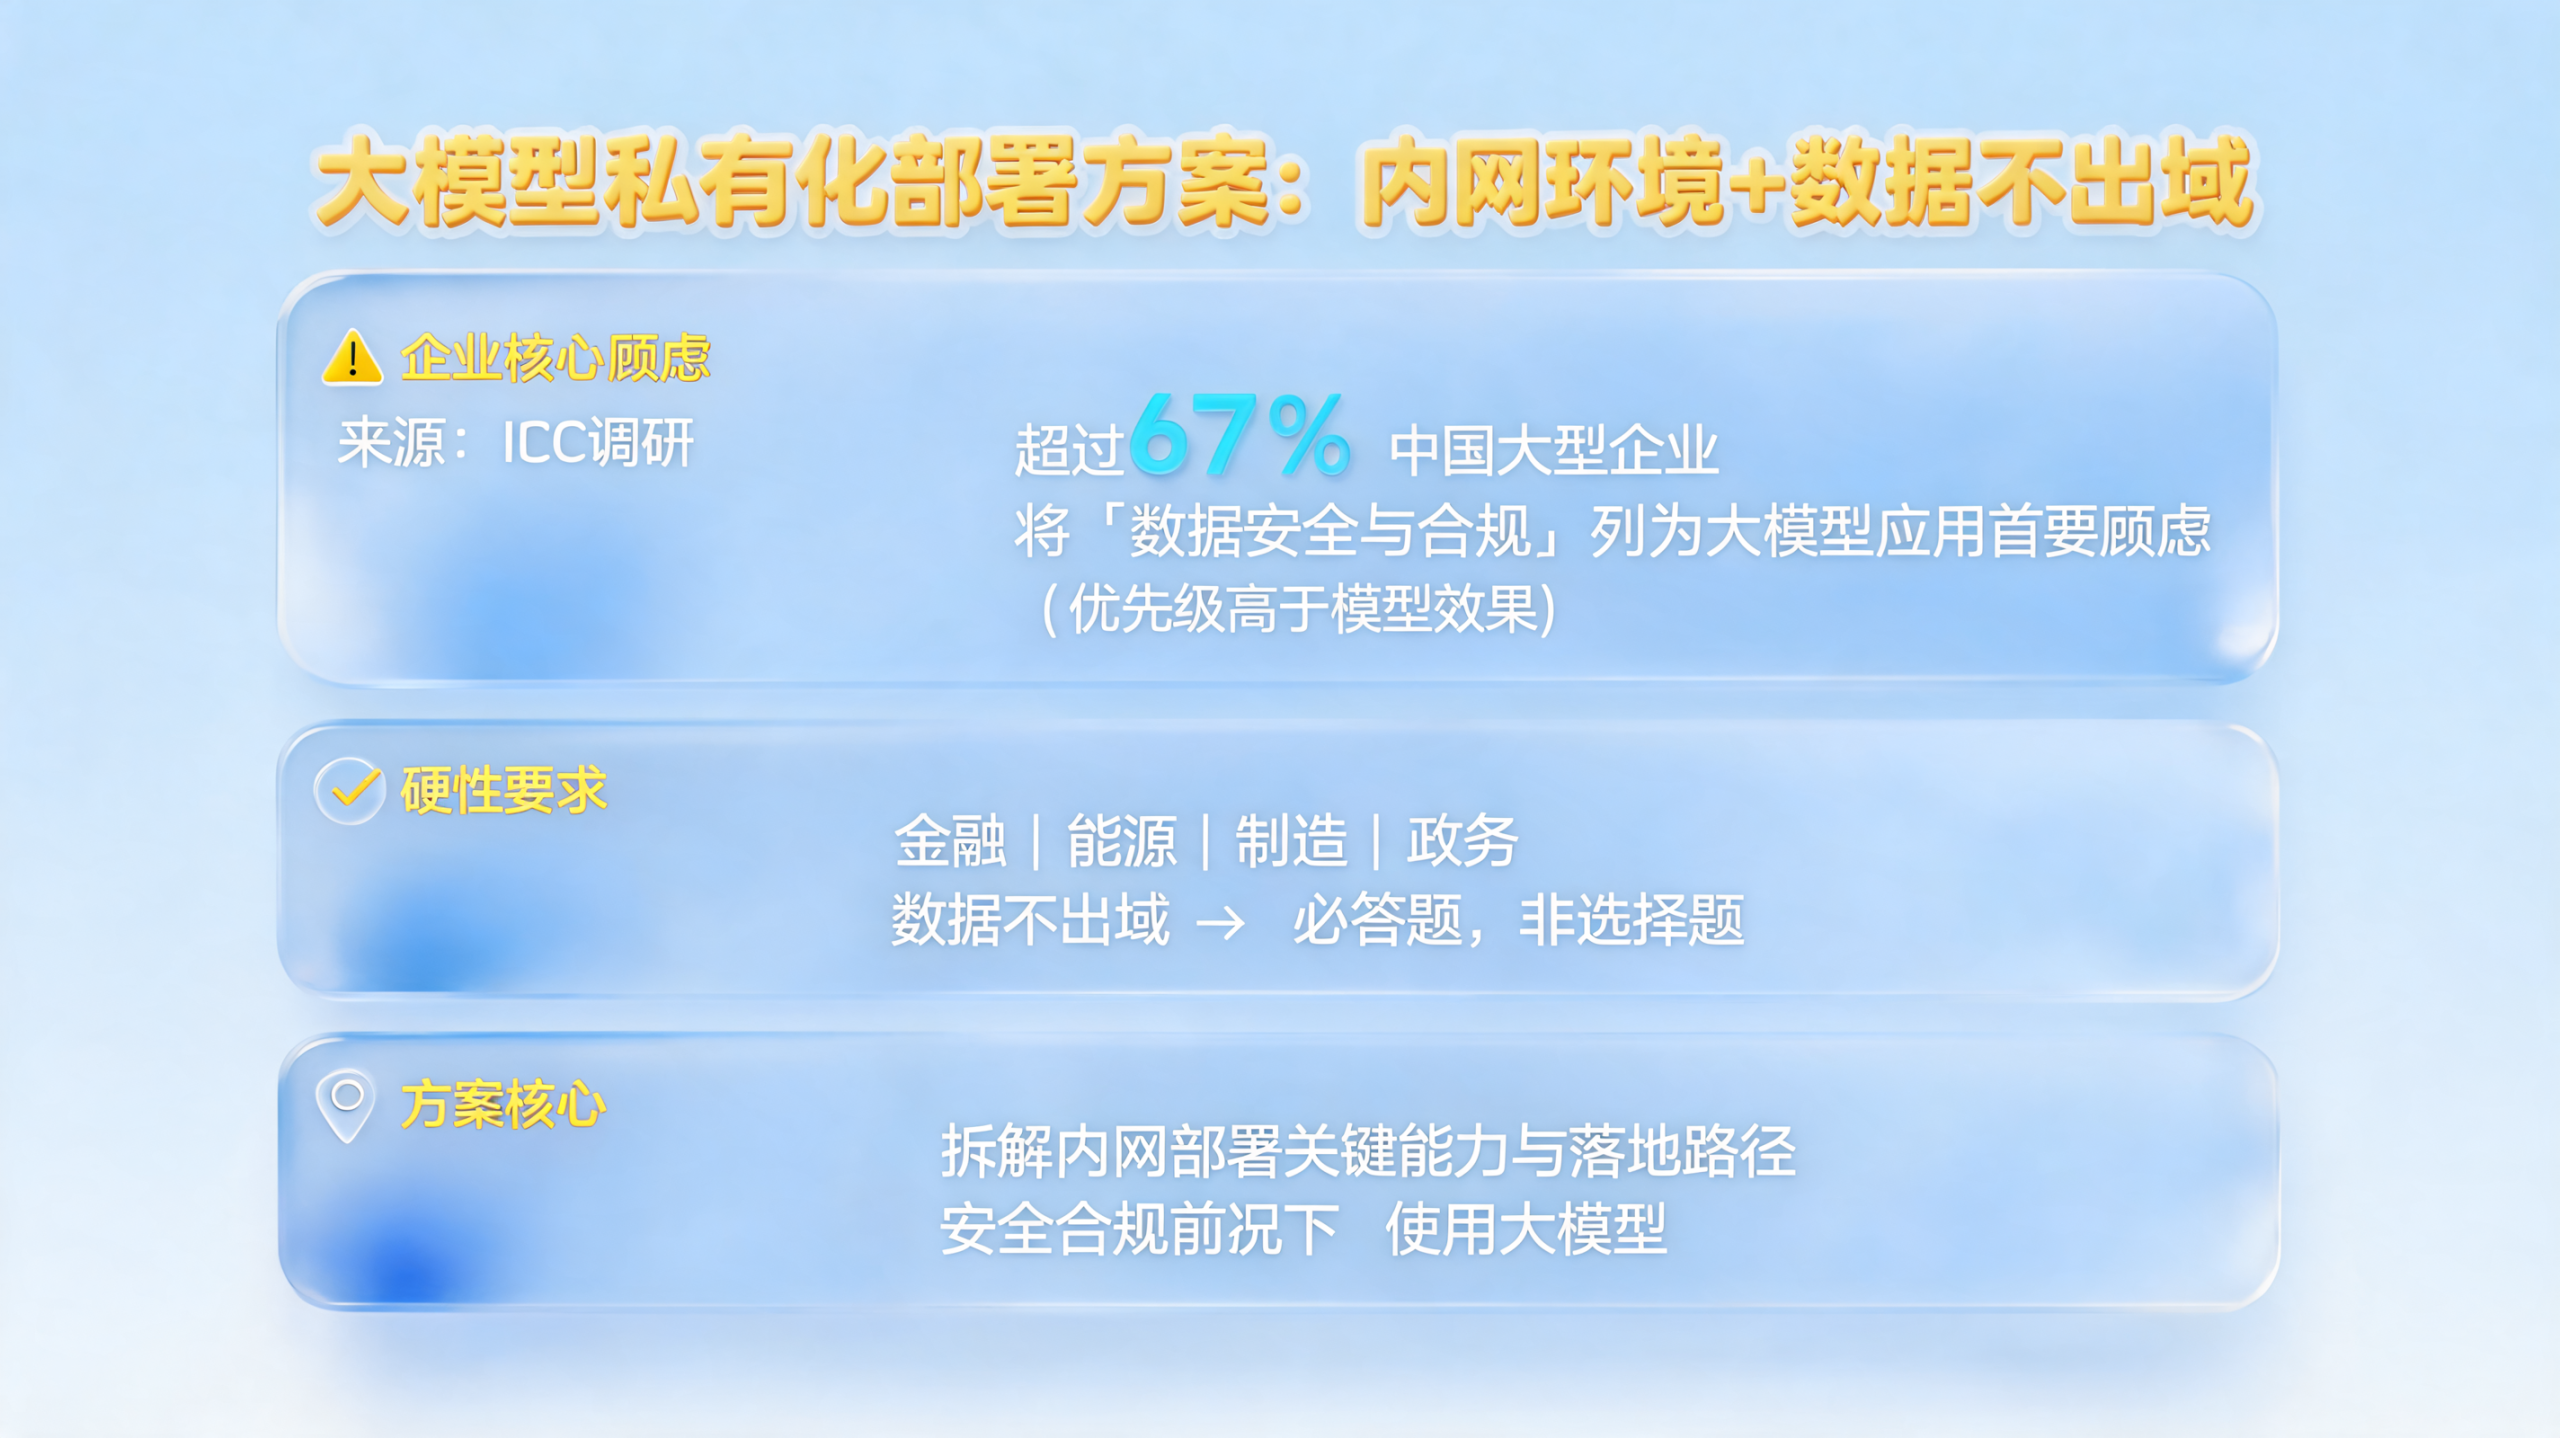
随着生成式AI的普及,许多企业试图利用大模型提升财务效率,如自动审核发票、银企对账等。然而,IDC调研显示,超过67%的中国大型企业将“数据安全与合规”列为首要顾虑。对于包含银行流水、成本核算表及客户隐私的敏感财务数据,一旦通过公有云API传输,即面临数据出域、审计盲区及合规处罚的巨大风险。
如何在享受AI红利的同时,确保企业内部安全部署本地大模型以处理敏感财务数据而不泄露隐私?核心答案在于“私有化部署”与“数据不出域”。
一、为何高敏感财务场景必须选择本地部署?
公有云大模型虽便捷,但在处理核心经营数据时存在“三不”困境:不敢用(责任主体在企业)、不好用(缺乏内部业务语境)、不划算(规模化后Token成本高)。
本地部署(On-Premises)的核心价值在于:
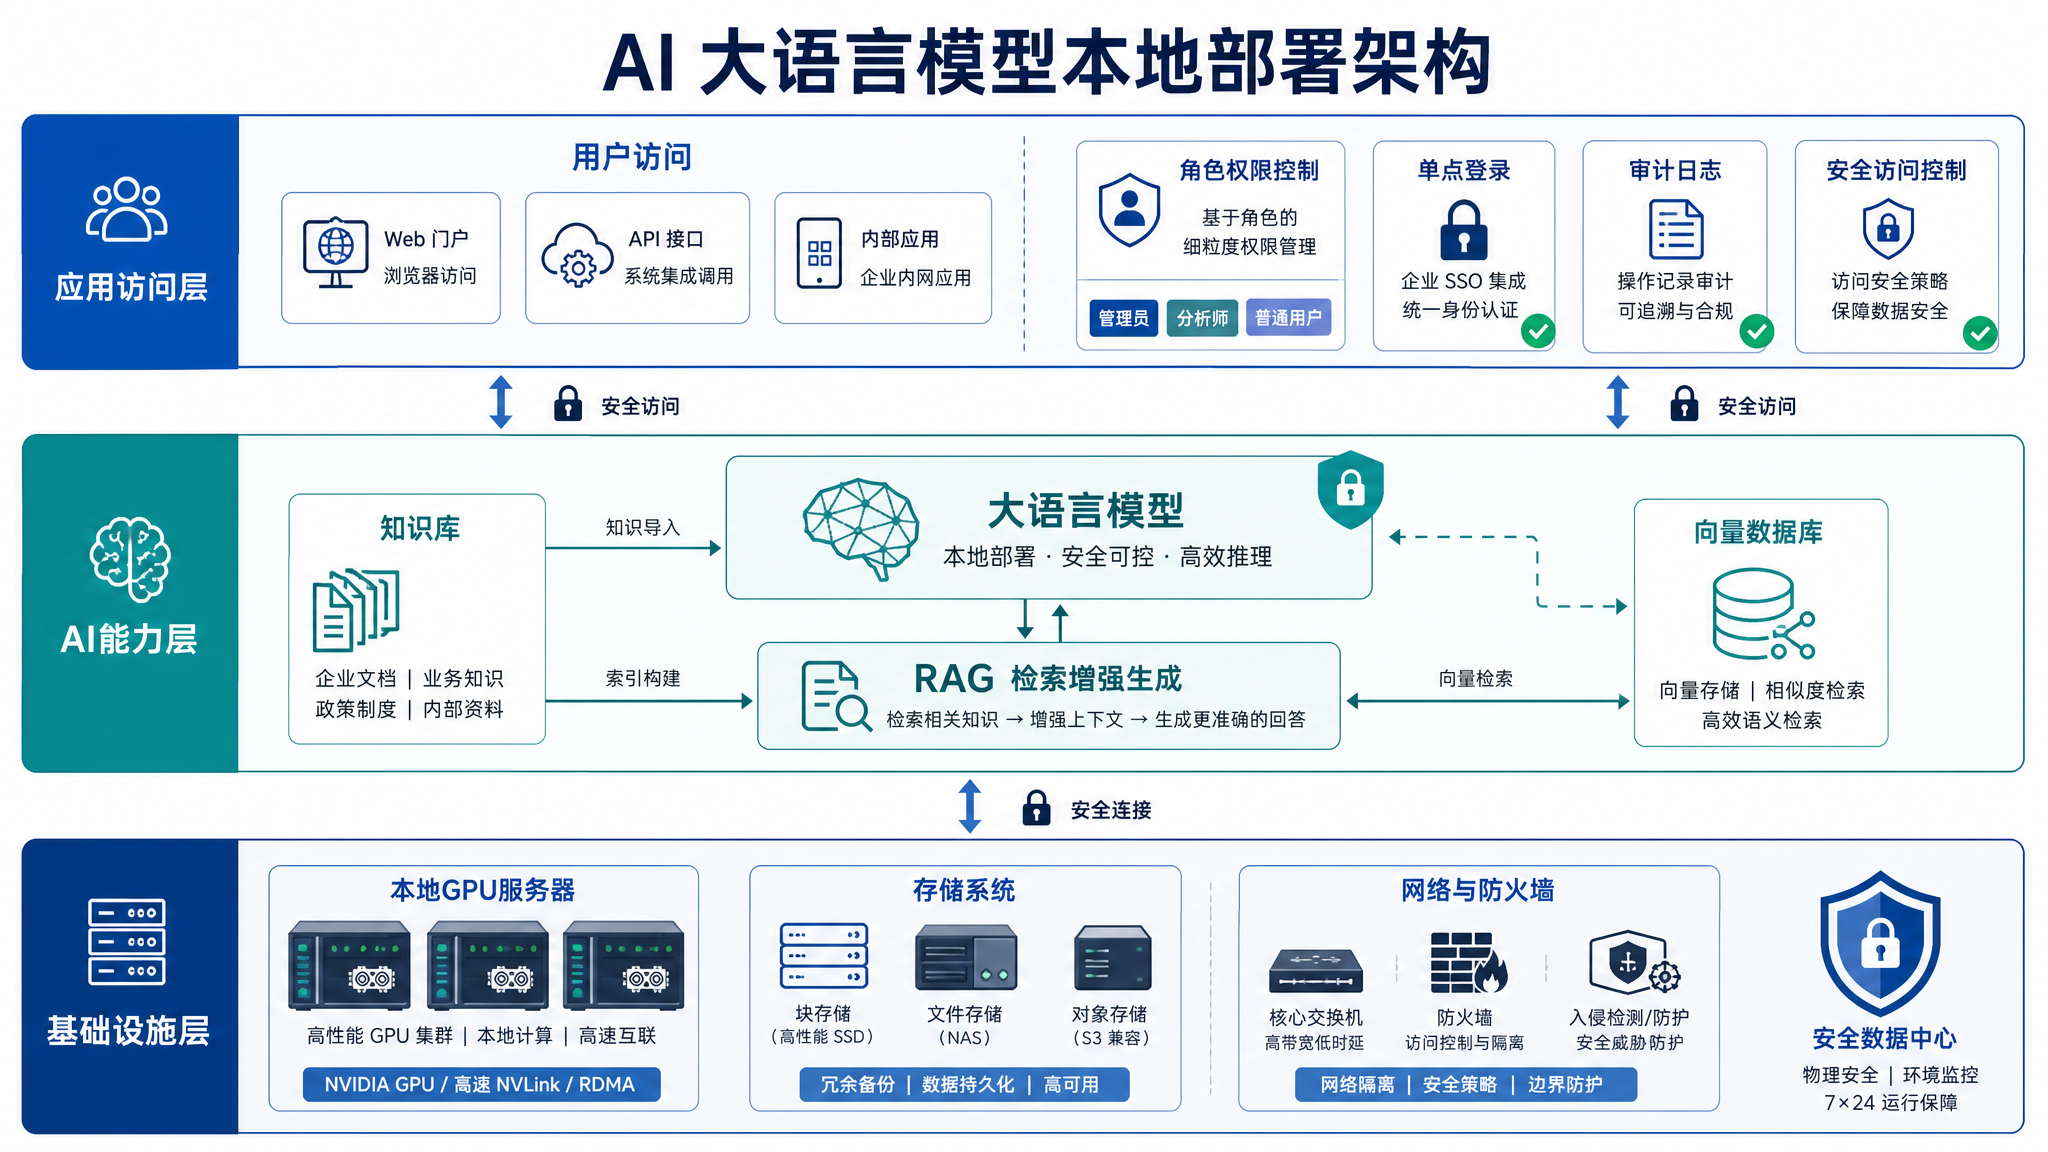
- 数据物理隔离:所有推理、微调及知识库检索均在内网完成,数据零外传。
- 细粒度权限管控:可按部门、角色设置访问边界,确保“该看的人看得到”。
- 审计可追溯:完整的操作日志满足金融级合规要求。
二、从选型到落地:构建安全闭环的工程路径
实现本地大模型安全部署并非简单安装软件,而是一套涵盖硬件、模型、框架及安全策略的系统工程。
1. 硬件与模型选型:平衡性能与成本
根据显存估算公式,7B-14B参数级别的模型适合部门级应用,单台配备高性能GPU(如A10/A100)的服务器即可支撑。对于集团级高并发场景,则需多卡集群。
- 开源模型:如Qwen、DeepSeek、Llama 3,适合技术团队强、需深度定制的企业。
- 推理框架:生产环境推荐vLLM(高吞吐),测试环境可用Ollama(易上手)。
2. 安全防护体系:不止于内网
本地部署不等于绝对安全,需配合以下措施构建分层防御:
- 网络隔离:配置防火墙规则,仅开放必要端口,禁止非授权转发。
- 容器化部署:使用Docker等技术隔离运行环境,提高资源利用率与管理便捷性。
- 数据加密与备份:对静态存储数据加密,并建立定期备份与恢复机制。
三、业务价值:非侵入式集成释放财务生产力
安全是底线,价值是目的。成熟的私有化方案可通过“ISSUT屏幕语义理解”等非侵入式技术,无需改造老旧ERP系统即可实现:
- 发票智能审核:自动读取影像,本地模型进行语义校验,异常自动标记。
- 银企智能对账:多源数据自动采集与匹配,准确率可达100%。
- 自然语言问数:业务人员通过对话查询经营数据,打通数据孤岛,效率提升90%以上。
四、总结与建议
对于金融、制造等高敏感行业,如何在企业内部安全部署本地大模型的关键在于坚持“数据不出域”原则,并结合RAG知识库增强模型业务能力。建议企业采取“试点验证-场景扩展-全域推广”的路径,先从小范围高频场景(如发票审核)入手,逐步建立人机协作规范与运维体系。
真正的智能,首先要让企业感到安全。与其在公有云边缘试探,不如在内网土壤扎根,构建自主可控的AI基础设施。