引言:销售数据转化的隐私困境
在销售团队日常工作中,大量的客户沟通以语音形式存在。人工听录音不仅效率低下,且难以全面覆盖。然而,直接将包含敏感信息的通话录音上传至公有云AI平台,又面临着严峻的客户隐私泄露风险。如何在不泄露客户隐私的前提下利用本地部署的大模型自动整理销售通话记录并提取关键需求,成为许多企业数字化转型的核心痛点。
本文将结合RAG(检索增强生成)技术与本地化部署方案,提供一套兼顾数据安全与业务效率的实战思路。
核心挑战:为何通用AI无法直接处理销售录音?
- 数据隐私红线:销售通话涉及客户姓名、联系方式、预算等核心机密,严禁上传至第三方不可控的API接口。
- 领域知识缺失:通用大模型不懂企业内部的产品术语、报价策略及销售流程,导致提取的需求不准确。
- 非结构化数据难题:语音是典型的非结构化数据,直接让大模型“听”音频成本高且效果差,需先转为文本再处理。
解决方案架构:本地部署 + RAG技术
为解决上述问题,我们采用“本地ASR转写 + 本地向量知识库 + 本地/私有化大模型”的技术架构。其中,RAG(Retrieval-Augmented Generation,检索增强生成)是关键桥梁,它让大模型能够基于企业私有数据生成准确回答,而非依赖训练时的过时知识。
1. 语音转文本(ASR):第一步数字化
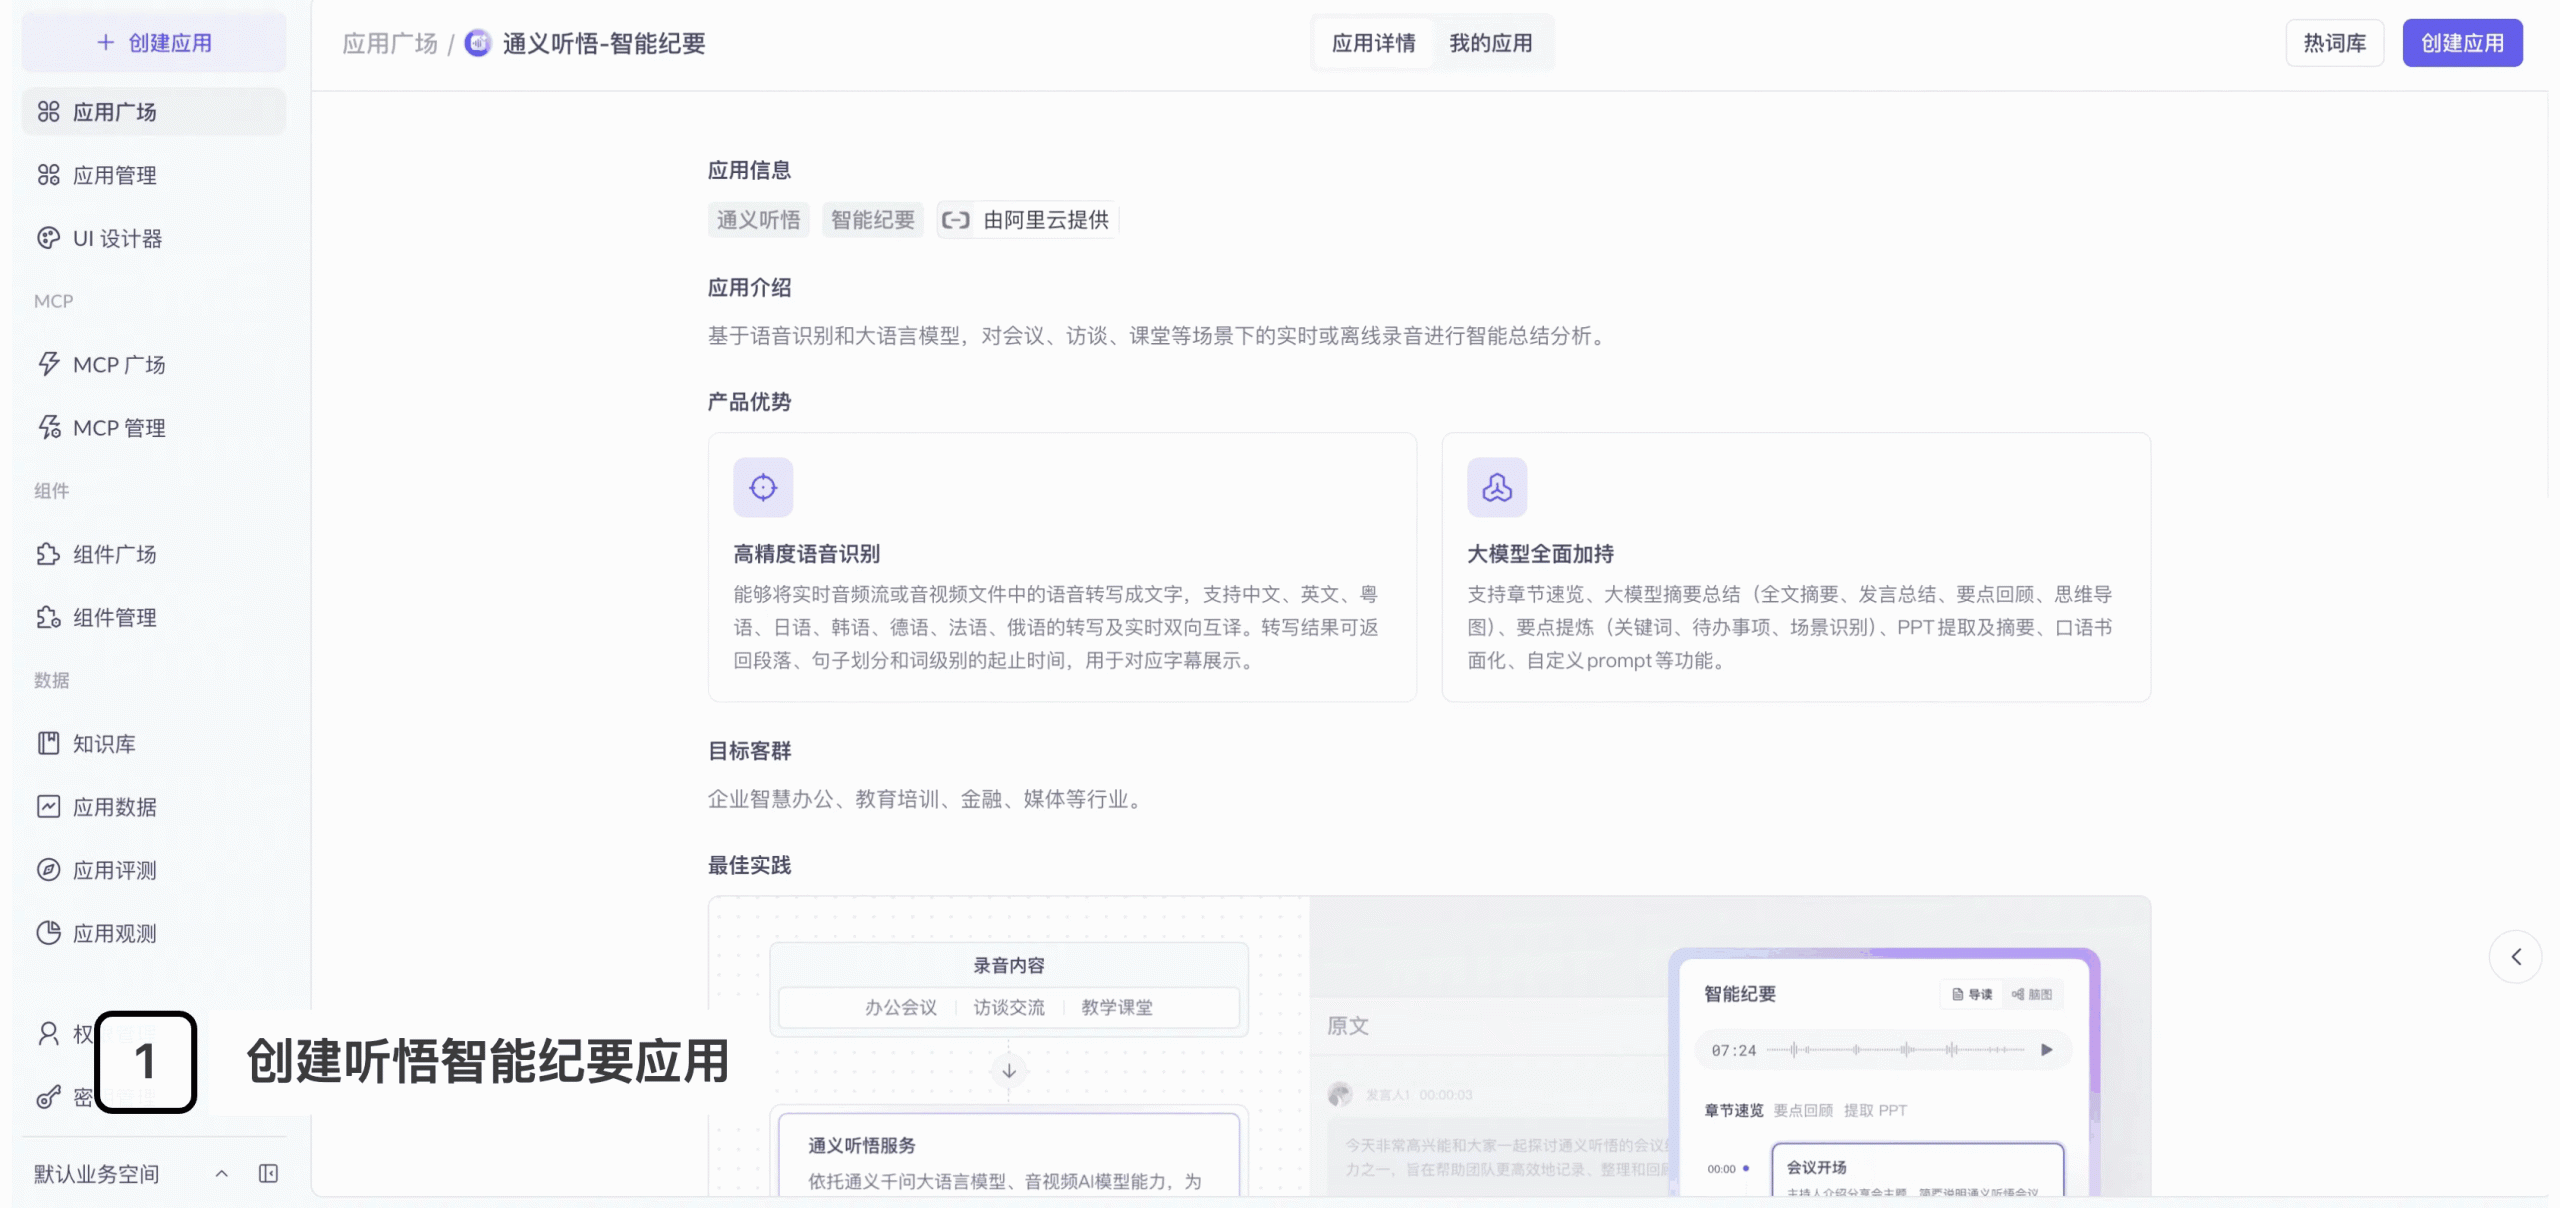
首先,需将录音文件转化为文本。可以使用支持本地部署或私有云部署的ASR工具(如通义听悟的私有化方案或开源Whisper模型),确保原始音频数据不出内网。这一步实现了从“听”到“读”的转变,为后续分析打下基础。
2. 构建私有向量知识库(RAG核心)
将转写后的文本以及企业的产品手册、销售话术库导入本地向量数据库(如ChromaDB)。通过文本分块(Chunking)和向量化(Embedding),将非结构化文本转化为机器可理解的向量数据。
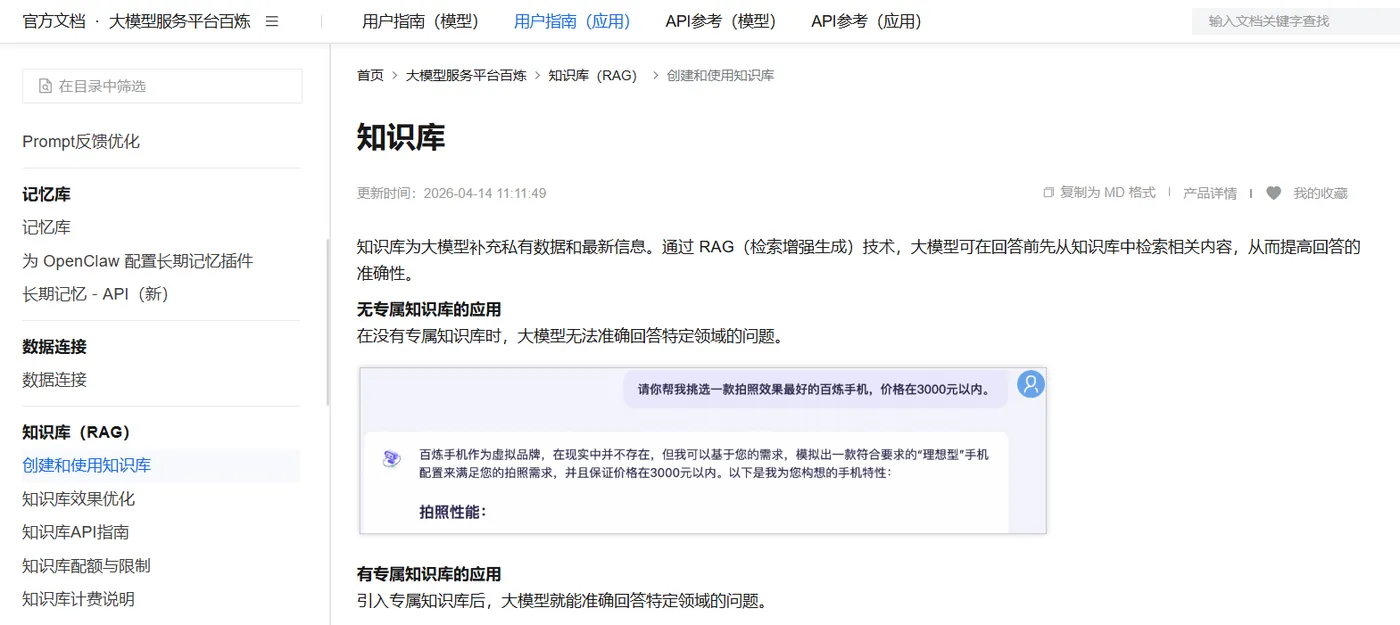
在此阶段,需注意文档分块策略。对于销售对话,建议保持较小的分块尺寸(如300-500字),以保留上下文的连贯性,同时避免噪声干扰。
3. 本地大模型推理与需求提取
使用本地部署的大语言模型(如通过Ollama运行的Llama 3或Qwen系列),结合LangChain框架搭建问答链。当需要提取某段录音中的“客户预算”或“痛点”时,系统会先在向量库中检索相关片段,再交由大模型总结。
这种方式确保了所有计算均在本地服务器完成,数据全程不离开企业内网,彻底杜绝隐私泄露风险。
实战步骤:从零搭建本地销售洞察系统
对于具备一定开发能力的团队,可以参考以下步骤快速验证:
- 环境准备:安装Python 3.11+、VS Code,并配置LangChain、ChromaDB等依赖库。
- 数据接入:编写脚本加载本地TXT或PDF格式的销售记录,使用RecursiveCharacterTextSplitter进行智能分块。
- 向量化存储:调用HuggingFace上的开源Embedding模型(如all-MiniLM-L6-v2)生成向量并存入ChromaDB。
- 模型对接:通过OpenAI兼容接口连接本地部署的大模型(如DeepSeek或SiliconFlow提供的私有化服务),设置Temperature参数以降低随机性,提高提取准确性。
优化技巧:提升需求提取的准确率
- 混合检索:结合关键词搜索(BM25)和向量搜索,提高对特定产品名词的召回率。
- 重排序(Rerank):在检索结果后增加重排序步骤,筛选出与“客户需求”最相关的片段,减少大模型的幻觉。
- 提示词工程:在Prompt中明确角色设定,例如“你是一名资深销售总监,请从以下对话中提取客户的显性需求和隐性顾虑”,并规定输出JSON格式以便后续入库。
总结
通过本地部署大模型结合RAG技术,企业不仅能在不泄露客户隐私的前提下利用本地部署的大模型自动整理销售通话记录并提取关键需求,还能构建起属于自己的私有知识资产。这种方案既满足了合规要求,又极大提升了销售管理的精细化水平,是未来智能销售系统的必然趋势。