痛点:几百份PDF合同,手动转换太崩溃
在法务、财务或行政工作中,经常需要处理大量历史存档的PDF合同。这些文件往往包含复杂的表格、印章、手写签名以及特定的排版格式。传统的OCR软件不仅识别率低,还经常打乱段落顺序,导致后期校对工作量巨大。如何批量将几百个PDF合同转换成可编辑的Word文档并保持原有排版格式,成为提升办公效率的关键难题。
核心难点:为什么普通转换工具不行?
普通的PDF转换器通常基于简单的文本提取逻辑,难以应对以下场景:
- 复杂版面还原难:多栏布局、跨页表格、合并单元格容易错位。
- 非标准元素丢失:公式、特殊符号、图片位置无法精准对应。
- 批量处理能力弱:缺乏自动化工作流,几百个文件需逐个操作。
解决方案一:MinerU 开源高精度解析引擎
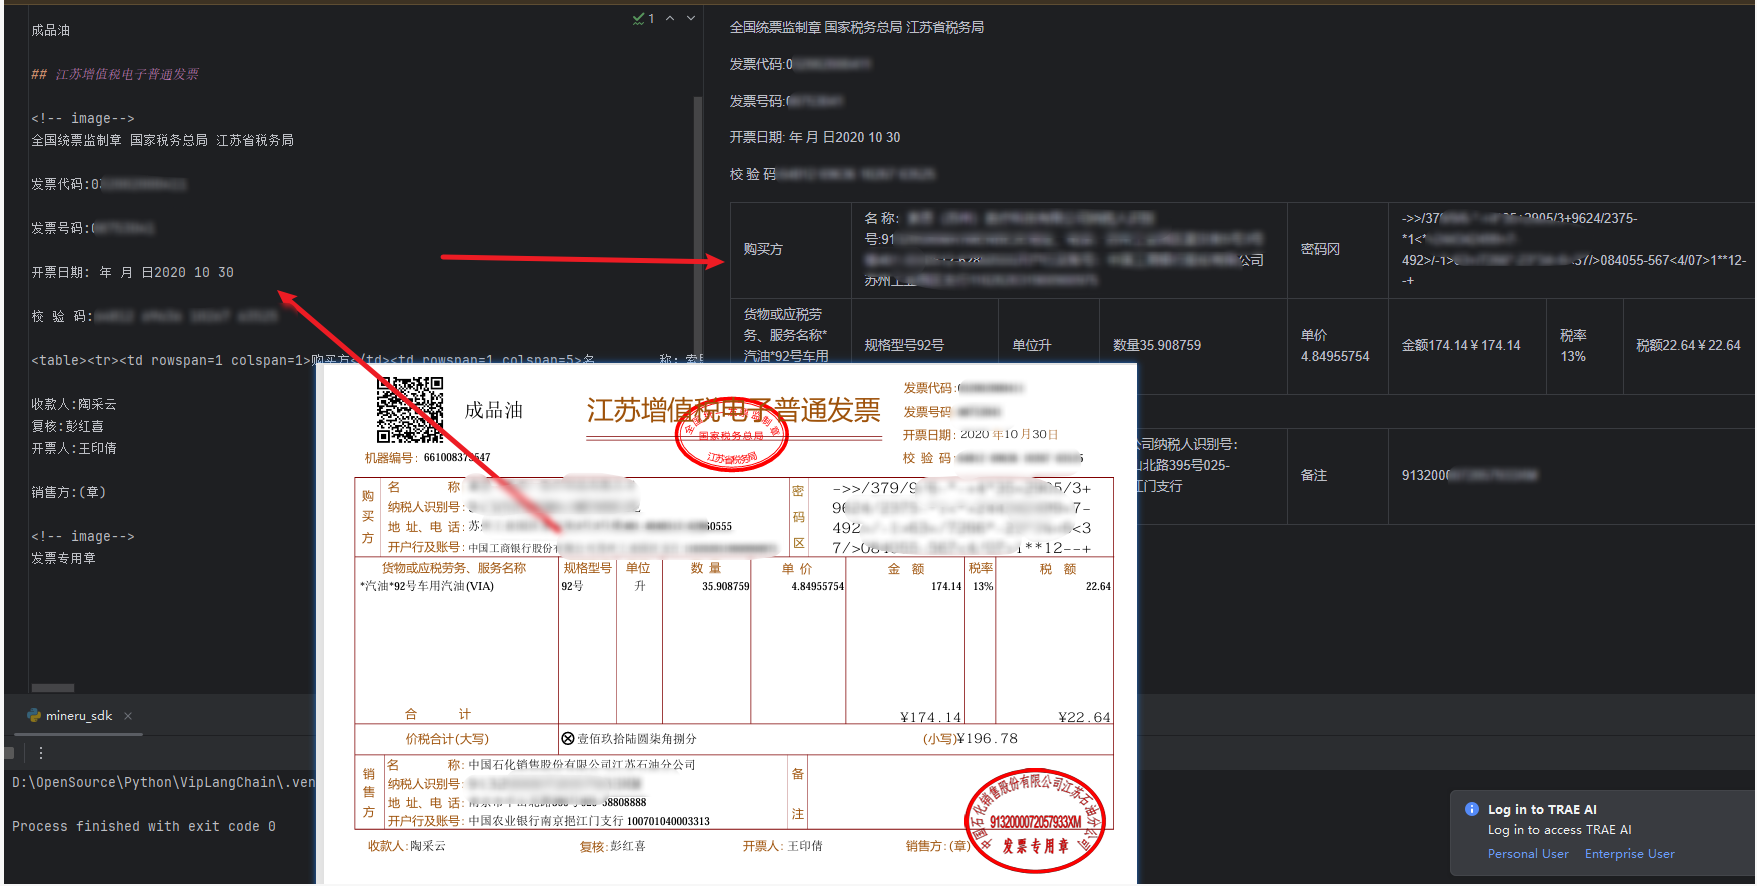
MinerU 是一款专为LLM预训练和RAG场景设计的开源文档解析引擎。它不仅能将PDF转换为Markdown,还支持直接导出为DOCX格式,特别适合对排版还原度要求极高的场景。
核心优势:
- VLM + OCR 双引擎:支持109种语言,能精准识别扫描件和手写体。
- 复杂结构还原:公式自动转为LaTeX,表格转为HTML,完美保留阅读顺序。
- 批量处理接口:提供Python SDK,支持
extract_batch异步批量处理,轻松应对数百个文件。
通过调用MinerU的API,用户可以指定extra_formats=["docx"]参数,直接将解析结果保存为Word文档。对于敏感数据,还可选择离线部署模式,确保数据安全。
解决方案二:TextIn xParse + Dify 自动化工作流
如果希望零代码实现自动化,TextIn xParse插件结合Dify平台是一个极佳选择。TextIn xParse支持多种解析引擎(如TextIn自研引擎、MinerU、PaddleOCR),可根据文档类型灵活切换。
实战步骤:
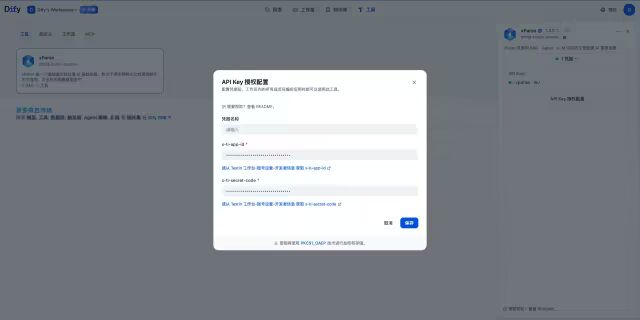
- 安装插件:在Dify市场安装xParse插件并配置API Key。
- 创建工作流:使用“迭代”节点遍历文件列表,调用xParse进行解析。
- 格式转换:xParse默认输出Markdown,可通过代码节点将其转换为Base64或直接利用其结构化数据重建Word文档。
- 批量归档:结合S3插件,将转换后的文档自动上传至云端存储。
这种方案特别适合构建企业级的“合同智能处理Agent”,不仅能转换格式,还能进一步提取合同中的关键条款信息。
解决方案三:阿里云文档智能格式转换
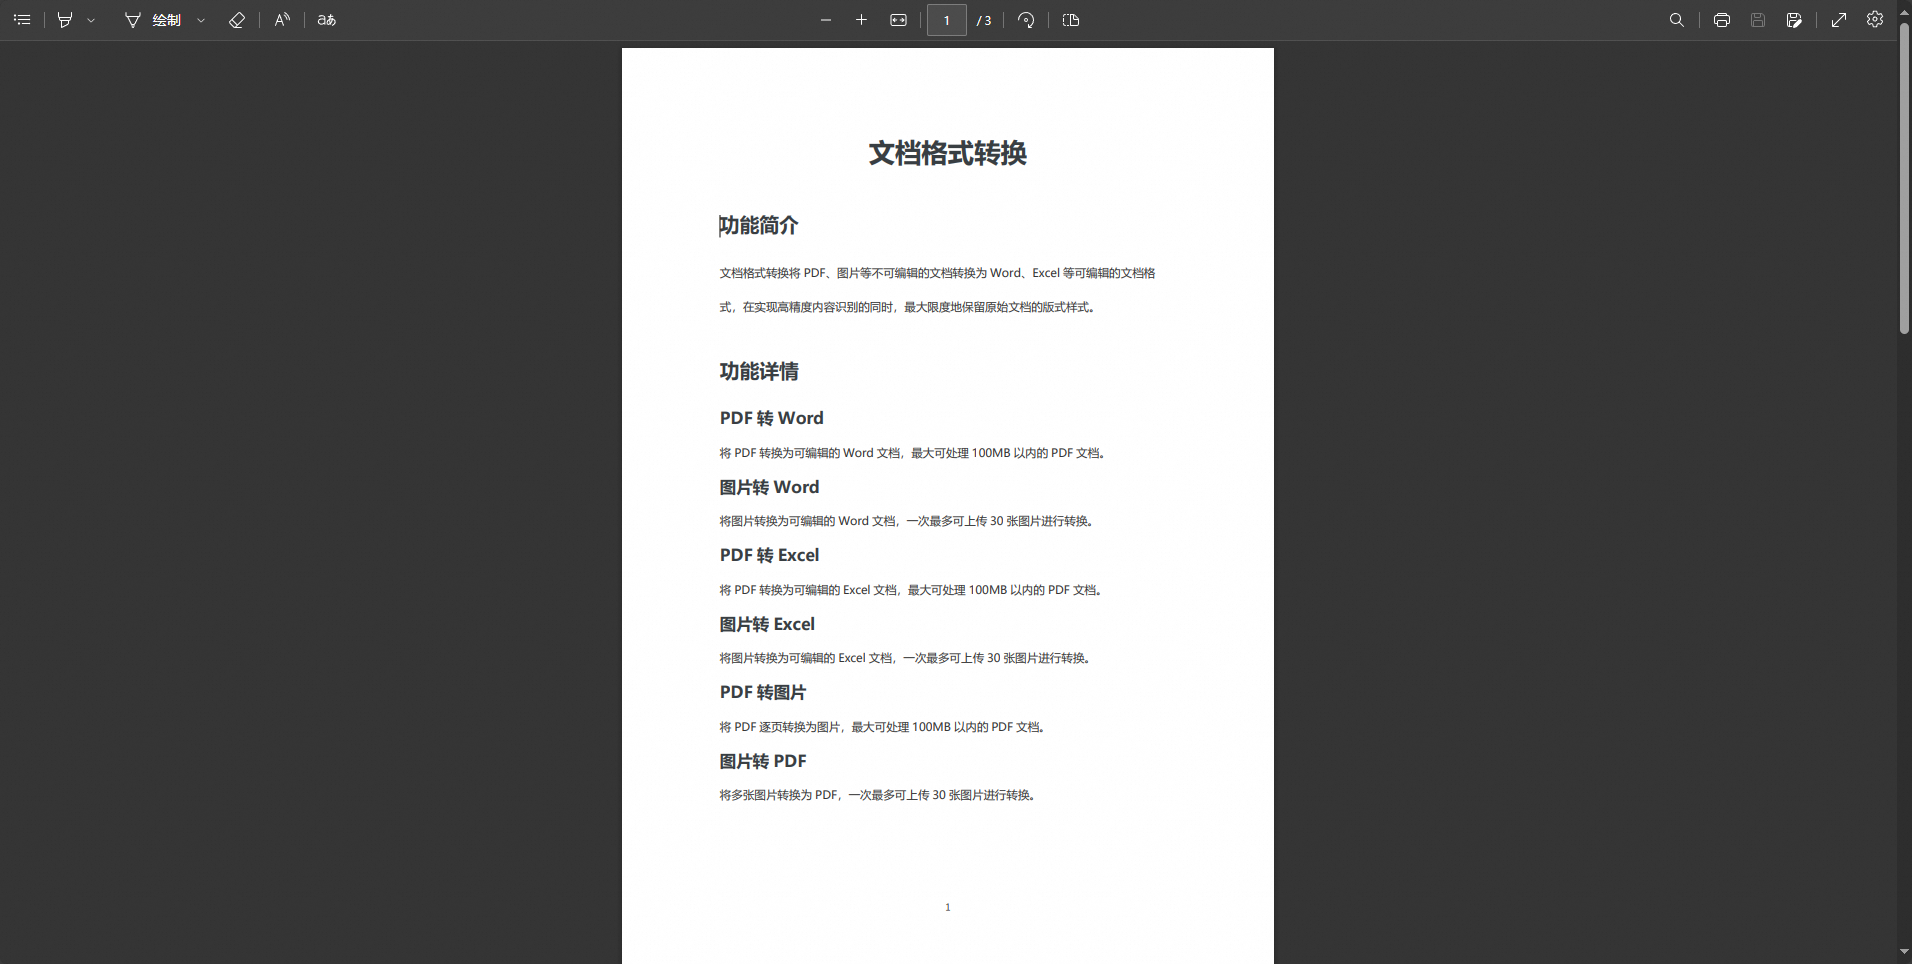
对于追求极致稳定性和无需自建环境的用户,阿里云提供的文档格式转换服务提供了成熟的商业化方案。该服务支持最大100MB的PDF文件,单次可处理30张图片,具备高精度的版面还原能力。
适用场景:
- 日常办公:快速将PDF论文、课件、合同转为可编辑的Word或Excel。
- 高保真需求:支持字体、字号、加粗、下划线及单元格合并样式的精准还原。
虽然主要面向云端API调用,但其强大的识别精度为解决“扫描件转Word”提供了可靠保障,尤其适合处理带有印章和批注的复杂文书。
总结与建议
针对如何批量将几百个PDF合同转换成可编辑的Word文档并保持原有排版格式这一问题,不同团队可根据自身技术栈选择方案:
- 开发者/技术团队:推荐使用 MinerU,通过Python SDK实现高度定制的批量转换与数据结构化。
- 业务/运营团队:推荐利用 Dify + TextIn xParse 搭建可视化工作流,实现零代码自动化处理。
- 企业级稳定需求:可直接接入 阿里云文档智能 等云服务,享受高并发、高精度的转换服务。
通过引入AI驱动的文档解析技术,原本需要数天的人工校对工作,现在可在短时间内高质量完成,真正实现办公自动化升级。