引言:企业知识管理的困境与破局
在数字化转型的浪潮中,企业积累了海量的文档资产,从客户案例、技术手册到内部制度,这些分散在各系统中的隐性经验往往难以被高效调用。通用大模型虽然强大,但存在三大核心痛点:数据隐私安全风险、领域专业知识缺失以及信息实时性差。员工无法将敏感的内部文档上传至公有云平台,而通用模型又无法知晓企业最新的业务动态。
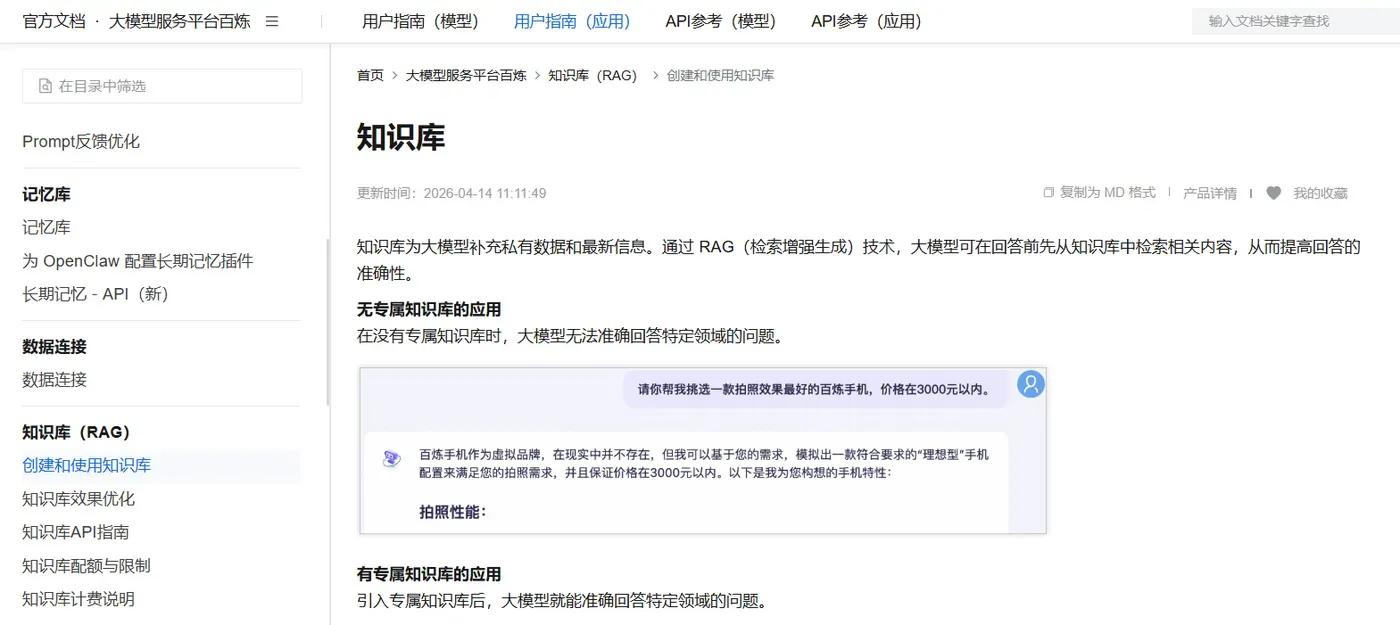
如何搭建基于私有文档的企业内部AI问答助手以保障数据隐私安全?答案在于RAG(检索增强生成)技术与私有化部署的结合。通过构建本地或私有云环境下的AI知识库,企业既能享受大模型的智能推理能力,又能确保核心数据始终留在内网,实现“数据不出域”的安全闭环。
” alt=”RAG技术架构示意图”>
一、为什么企业必须选择私有化AI部署?
公有云方案适合处理低敏感度的通用任务,但当涉及合同、财报、核心技术文档时,私有化部署的价值便凸显出来。其核心优势并非炫技,而是可控性:
- 数据隐私绝对掌控:所有文档解析、向量化存储及推理过程均在企业本地服务器或私有云完成,从源头规避泄露风险,符合金融、医疗、政务等行业的合规要求。
- 领域知识深度适配:通过导入企业内部专属资料,让AI学习行业术语与业务逻辑,回答不再泛泛而谈,而是精准贴合实际场景。
- 实时动态更新:新政策、新产品文档可随时入库,AI即时掌握最新信息,摆脱训练数据的时间滞后性。
对于文件敏感度高、权限结构复杂或计划将AI深度接入内部流程的企业,私有化是更稳健的选择。
” alt=”私有化部署决策因素”>
二、核心技术原理:RAG如何实现智能问答
RAG(Retrieval-Augmented Generation)即检索增强生成,其运行逻辑形成了一个标准化闭环:
- 文档处理:系统自动解析PDF、Word、TXT等格式文档,进行文本清洗与分块(Chunking)。
- 向量化存储:利用嵌入模型(Embedding Model)将文本片段转化为向量数据,存入向量数据库(如OceanBase、LanceDB等)。
- 语义检索:用户提问时,系统将问题转化为向量,在数据库中检索最相关的知识片段。
- 增强生成:将检索到的上下文与用户问题一同送入大语言模型(LLM),生成基于事实的专业回答。
这种架构既避免了大模型的“幻觉”,又实现了基于私有数据的精准问答。
” alt=”OceanBase与DeepSeek结合的RAG流程”>
三、从零搭建:技术选型与实施路径
搭建私有AI知识库并非高不可攀,可根据企业规模与技术能力选择不同路径。
1. 轻量级本地部署(适合中小团队/个人)
对于资源有限或追求快速验证的场景,可采用“Ollama + AnythingLLM”方案:
- 模型引擎:使用Ollama本地运行量化版大模型(如Qwen2-7B),无需GPU也能在普通PC上流畅运行。
- 知识库工具:部署AnythingLLM桌面版或Docker容器,支持拖拽上传文档,自动完成切片与向量化。
- 关键配置:务必选用支持中文的向量模型(如bge-large-zh),并调整分块重叠参数以提升检索准确率。
2. 企业级私有云部署(适合大型组织)
对于高并发、高安全要求的场景,建议采用更稳健的技术栈:
- 数据库:选用支持向量检索的关系型数据库(如OceanBase 4.3+版本),实现结构化数据与向量数据的统一存储,简化运维。
- 大模型:接入国产开源模型(如DeepSeek、通义千问),通过API或本地部署降低调用成本,适配中文语境。
- 前端交互:使用Streamlit或集成至钉钉、飞书等企业IM,实现无缝触达。
” alt=”私有知识库代码实现与架构”>
四、避坑指南与优化策略
在实际落地过程中,许多企业容易陷入误区。以下是经过实践验证的优化建议:
- 避免“大而全”:不要试图一次性覆盖所有知识。建议从客服支持、内部培训等高频刚需场景切入,小步快跑,快速迭代。
- 重视数据治理:知识内容治理可能占据60%的工作量。需建立文档清洗、版本管理及过期下架机制,确保入库知识的质量与时效性。
- 优化检索效果:若回答不准确,可尝试混合检索(向量+关键词)、调整分块大小(技术文档小块、制度文档大块)或引入重排序(Rerank)机制。
- 关注运维成本:私有化不仅是硬件投入,更需考虑Linux维护、备份监控及人员能力。若无基础IT团队,需谨慎评估长期运维压力。
结语
搭建基于私有文档的企业内部AI问答助手,不仅是技术的升级,更是企业知识管理模式的革新。通过RAG技术与私有化部署的结合,企业能够将分散的知识资产转化为可复用、可智能调用的核心竞争力,在保障数据隐私安全的前提下,大幅提升办公效率与决策质量。摒弃完美主义,从最小可行产品(MVP)开始,让AI真正成为员工的“第二大脑”。